用 Rust 从头实现机器学习算法·回归①:OLS 与梯度下降
用 Rust 从头实现机器学习算法·回归①:OLS 与梯度下降
基础篇备好了 Matrix,从本篇起进入系列的主线:逐个实现算法清单上的机器学习算法。第一个是最古老也最重要的——一元线性回归。整个过程分三步:先定义”什么叫拟合得好”,再算出”往哪个方向改参数会更好”,最后写一个循环反复改进。数学只需要链式法则,推导一步步展开。
核心思想
假设我们有一组数据点 ,,大致落在一条直线附近。线性回归要找到这条直线的两个参数:斜率 和截距 ,使预测值
尽可能接近真实的 。找到之后,给定新的 就能预测 ——这就是”学习”。
算法清单对 OLS 的原文描述是:
核心思想:找到一条直线(或超平面),使所有样本点的「残差平方和」最小——最小二乘(Ordinary Least Squares)。
顺带说明一个背景:OLS 其实存在闭式解 (正规方程,第二篇埋下过伏笔),但本篇刻意不用它,而是从损失函数出发用梯度下降迭代求解。原因是梯度下降是后面所有没有闭式解的模型(逻辑回归、神经网络……)的通用底座,值得先在只有 两个参数的最简单地形上走一遍;“损失 → 梯度 → 更新”这三板斧将贯穿整个系列。
数学推导
第一步:损失函数——量化”拟合得好不好”
对样本 ,预测 ,残差定义为 。直接求和 会让正负误差抵消,因此 OLS 最小化残差平方和。本文采用
除以 让损失尺度不随样本量膨胀,多出的 用来抵消求导后的 2;它们不改变最优参数。代码中的 loss 是这个 ,而评估时常说的 MSE 是 ,比较不同实现的数值时必须先对齐这个因子。
OLS 与梯度下降不是两个模型。 OLS 规定”最小化平方误差”这个目标;正规方程和梯度下降只是两种求解器。本篇刻意选择后者,是为了练习后面逻辑回归等无闭式解模型也会使用的优化框架。
第二步:求梯度——算出”往哪走”
固定 对 求偏导,链式法则先处理平方,再乘以内层 对 的导数 :
同理,内层对 的导数为 1:
每个样本的残差就是它对参数的推动力:平均残差推动截距,残差按 加权后推动斜率。更新规则沿负梯度走一步:
太大可能跨过谷底,太小则收敛慢;由于平方损失关于 是凸二次函数,合适步长下不会因为”局部坑”困在较差点,但特征尺度会显著影响速度。
一个两步样本的完整首轮计算
先用只有两个点的最小例子把手算和代码变量一一对上:、,初始化 ,学习率 。首轮两个残差为
于是
更新后
新预测为 ,比原来的零直线更接近这两个点。程序对 200 个样本做的事完全相同:diff 是 ,循环先累加 diff * xs[i] 与 diff,再分别除以 ,最后执行两次 -=。
闭式解从哪里来:梯度置零与正交投影
把截距列并入设计矩阵 ,参数记为 ,则梯度为 。令其为零得到正规方程:
当 可逆时,。几何上, 是 到 列空间的正交投影,因为 :残差与每个特征方向都正交,列空间内已没有能继续降低平方误差的方向。
这条闭式路线无需迭代,但显式求逆并非最佳工程做法;库通常用 QR 或 SVD 类最小二乘求解,以减少共线性带来的精度损失。本篇的梯度路线也有价值:损失、梯度和更新全部可见。
数学 ↔ 代码对应表
| 数学 | Rust 实现 |
|---|---|
内层循环的 diff | |
累加 loss += diff * diff 后 loss /= 2.0*n | |
dw += diff * xs[i] 后除以 n | |
db += diff 后除以 n | |
| 参数负梯度更新 | w -= lr * dw、b -= lr * db |
| 保存 收敛轨迹 | history.push((epoch, loss)) |
scikit-learn 对照:同一个 OLS,不同求解器
sklearn.linear_model.LinearRegression(fit_intercept=True) 与本篇拟合同一个无正则化最小二乘模型。它的普通分支调用 LAPACK 最小二乘例程,以 SVD 处理秩与病态问题,而不是手写梯度下降,也不要求学习率和 epoch。它也不会自动给出”梯度下降 2000 轮”这种训练曲线。
比较结果时应注意三点:本篇数据含噪声,最优系数不必恰好是 3 和 2;score() 默认是 而不是 MSE;LinearRegression 本身不提供正则化,岭、套索要换成其他估计器。工程数据上优先使用经过数值检验的库实现,手写版本则用来验证每一条更新为何发生。
Rust 实现
思路齐了,写代码。整个程序只依赖标准库,cargo run 即可运行。为了不引入外部依赖,我们手写一个经典的 xorshift 伪随机数生成器来造数据;文末的可视化则由一个内联的迷你 SVG 绘图器完成,两张图直接写进站点的静态资源目录。下面两段代码拼接起来就是完整的 src/main.rs。
首先是数据、训练与可视化主流程:
// 回归①:OLS 线性回归与梯度下降 —— 单文件实现(仅依赖 std)。
// 造数据 y = 3x + 2 + ε(xorshift64,种子 42),用梯度下降训练 w、b,
// 再用内联的迷你 SVG 绘图器输出拟合直线与 loss 收敛曲线。

use std::fmt::Write as _;

fn main() {
    // ---- 1. 生成模拟数据 y = 3x + 2 + ε ----
    let mut rng = XorShift::new(42);
    let n = 200usize;
    let mut xs = Vec::with_capacity(n);
    let mut ys = Vec::with_capacity(n);
    for _ in 0..n {
        let x = rng.next_f64() * 10.0 - 5.0;    // x ∈ [-5, 5)
        let eps = (rng.next_f64() - 0.5) * 2.0; // 噪声 ε ∈ [-1, 1)
        xs.push(x);
        ys.push(3.0 * x + 2.0 + eps);
    }

    // ---- 2. 初始化参数与超参数 ----
    let mut w = 0.0;
    let mut b = 0.0;
    let lr = 0.01;     // 学习率 η
    let epochs = 2000; // 迭代轮数

    // ---- 3. 训练循环:每轮先算损失与梯度,再沿梯度反方向更新参数 ----
    let mut history: Vec<(f64, f64)> = Vec::with_capacity(epochs);
    for epoch in 1..=epochs {
        let mut dw = 0.0;
        let mut db = 0.0;
        let mut loss = 0.0;
        for i in 0..n {
            let diff = w * xs[i] + b - ys[i]; // 预测误差 ŷ - y
            loss += diff * diff;
            dw += diff * xs[i];
            db += diff;
        }
        loss /= 2.0 * n as f64;
        dw /= n as f64;
        db /= n as f64;
        history.push((epoch as f64, loss));
        w -= lr * dw; // w ← w - η·∂L/∂w
        b -= lr * db; // b ← b - η·∂L/∂b
        if epoch == 1 || epoch % 200 == 0 {
            println!("epoch {:>4} | loss {:.6} | w {:.4} | b {:.4}", epoch, loss, w, b);
        }
    }
    println!("最终: w = {:.4}, b = {:.4}", w, b);

    // ---- 4. 可视化:拟合直线 + loss 收敛曲线 ----
    let out_dir = "../../../frontend/public/images/series/rust-ml-03-linear-regression";
    std::fs::create_dir_all(out_dir).expect("创建输出目录失败");

    // fit.svg:数据散点 + 训练后的拟合直线同框
    let line = vec![(-5.0, w * -5.0 + b), (5.0, w * 5.0 + b)];
    let pts: Vec<(f64, f64)> = xs.iter().copied().zip(ys.iter().copied()).collect();
    let (ymin, ymax) = y_range(&pts, &line);
    let mut fit = Canvas::new(560.0, 380.0, -5.0, 5.0, ymin, ymax);
    fit.axes("x", "y");
    fit.dots(&pts, "#d6491f", 3.0);
    fit.polyline(&line, "#0f766e", 2.0);
    fit.save(&format!("{out_dir}/fit.svg"));

    // loss.svg:loss 随 epoch 的收敛曲线
    let max_loss = history.iter().map(|p| p.1).fold(0.0, f64::max);
    let mut loss_canvas = Canvas::new(560.0, 320.0, 0.0, epochs as f64, 0.0, max_loss);
    loss_canvas.axes("epoch", "loss");
    loss_canvas.polyline(&history, "#d6491f", 2.0);
    loss_canvas.save(&format!("{out_dir}/loss.svg"));

    println!("SVG 已生成: {out_dir}/fit.svg, {out_dir}/loss.svg");
}

/// 数据点与拟合线端点的 y 值范围(绘图器自己再加 5% 边距)。
fn y_range(pts: &[(f64, f64)], line: &[(f64, f64)]) -> (f64, f64) {
    let mut ymin = f64::INFINITY;
    let mut ymax = f64::NEG_INFINITY;
    for (_, y) in pts.iter().chain(line.iter()) {
        ymin = ymin.min(*y);
        ymax = ymax.max(*y);
    }
    (ymin, ymax)
}

/// xorshift64 伪随机数生成器:无需外部依赖,结果可复现。
struct XorShift(u64);

impl XorShift {
    fn new(seed: u64) -> Self {
        assert!(seed != 0, "种子不能为 0");
        XorShift(seed)
    }

    fn next_u64(&mut self) -> u64 {
        let mut x = self.0;
        x ^= x << 13;
        x ^= x >> 7;
        x ^= x << 17;
        self.0 = x;
        x
    }

    /// 返回 [0, 1) 区间的 f64。
    fn next_f64(&mut self) -> f64 {
        (self.next_u64() >> 11) as f64 / (1u64 << 53) as f64
    }
}
实现要点:
- 训练循环与三个公式逐行对应:
diff是预测误差 ;dw、db累加后除以 ,正是 与 ;最后两行更新式与数学符号一一对应。对照检查一遍,代码里没有一处”魔法”。 loss、dw、db都在参数更新之前、基于本轮起点计算——先看清方向再迈步,顺序不能颠倒。- 相比旧版训练循环,这里多了一个
history:每轮的 存下来,既是 loss 收敛曲线的数据源,也让第 1 轮与最后几轮的 loss 直接出现在文本输出里。 - 可视化输出用相对路径加
create_dir_all:从series/rust-ml/rust-ml-03-linear-regression/运行cargo run,两张 SVG 直接写进站点的静态资源目录frontend/public/images/series/rust-ml-03-linear-regression/。
然后是迷你 SVG 绘图器(与系列其他文章共用同一份实现,series/rust-ml/_plotter-demo/ 里也有它):
// ---- 迷你 SVG 绘图器:零依赖(仅 std),把数据写成 SVG 文件 ----
// 这是系列文章的共享绘图工具,每篇文章的代码中都会内联同一份实现。

/// 一张图:坐标映射 + 已累积的 SVG 元素。
struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    /// 按数据范围自动留 5% 边距建图;xmin == xmax 时手动摊开避免除零。
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    /// 折线,点需按 x 升序传入。
    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    /// 散点。
    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    /// 坐标轴 + 虚线网格 + 刻度标签。
    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

/// 把 fmt 出来的 f64 末尾零去掉,让刻度标签短一点。
fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

/// 数据范围退化成一点时向两侧摊开。
fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

/// “好看”的刻度:步长取 1/2/2.5/5 × 10^k。
fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}
实现要点:
Canvas持有数据坐标范围和一个不断累积 SVG 元素的body字符串;px/py做数据坐标到像素的线性映射,py里有一次翻转——屏幕的 y 轴向下,数学的 y 轴向上。polyline、dots、axes、save四个方法覆盖折线、散点、坐标轴与落盘;刻度步长取 里”最好看”的一档。- 注意方法签名上的
&self与&mut self之分:只读的取&self,会往body里追加元素的取&mut self——这不是风格偏好,而是 Rust 借用规则的直接体现,马上细说。
Rust 语法角:借用与可变借用
Python 里变量是指向对象的引用(名字),list 天生可变:几个变量可以指向同一个列表,通过任何一个都能改它,语言并不阻止你一边遍历、一边在别处修改——这类”别名 bug”往往要到运行时才暴露。
Rust 把这件事管了起来,规则只有两条:
&T不可变借用:可以有很多个,但谁都不得修改原数据;&mut T可变借用:同一时刻只允许存在一个,且它活着的时候不允许有任何&T指向同一数据。
全部由编译器在编译期静态检查——违反即报错,而不是运行到那一行才崩。
回到训练循环,这两条规则体现得淋漓尽致:xs、ys 建好之后就再也不改,循环里读取 xs[i] 只是不可变借用,所以它们不需要 mut,&pts 还能同时借给多个绘图调用;而 w -= lr * dw 要修改 w,w 就必须声明为 mut——它拿到的是”独占的修改权”。绘图器的 API 是同一原则的对照组:dots 和 save 只读,签名是 &self;polyline 和 axes 会累积元素,签名是 &mut self。这套设计让数据竞争类错误在编译期就无处遁形。想深入可读《Rust 程序设计语言》第 4 章 References and Borrowing。
运行结果
运行 cargo run(随机数种子固定为 42,每次输出逐字节一致):
epoch    1 | loss 32.326143 | w 0.2093 | b 0.0061
epoch  200 | loss 0.202033 | w 2.9938 | b 1.6762
epoch  400 | loss 0.153697 | w 3.0136 | b 1.9466
epoch  600 | loss 0.152703 | w 3.0164 | b 1.9854
epoch  800 | loss 0.152683 | w 3.0168 | b 1.9910
epoch 1000 | loss 0.152682 | w 3.0169 | b 1.9918
epoch 1200 | loss 0.152682 | w 3.0169 | b 1.9919
epoch 1400 | loss 0.152682 | w 3.0169 | b 1.9919
epoch 1600 | loss 0.152682 | w 3.0169 | b 1.9919
epoch 1800 | loss 0.152682 | w 3.0169 | b 1.9919
epoch 2000 | loss 0.152682 | w 3.0169 | b 1.9919
最终: w = 3.0169, b = 1.9919
SVG 已生成: ../../../frontend/public/images/series/rust-ml-03-linear-regression/fit.svg, ../../../frontend/public/images/series/rust-ml-03-linear-regression/loss.svg
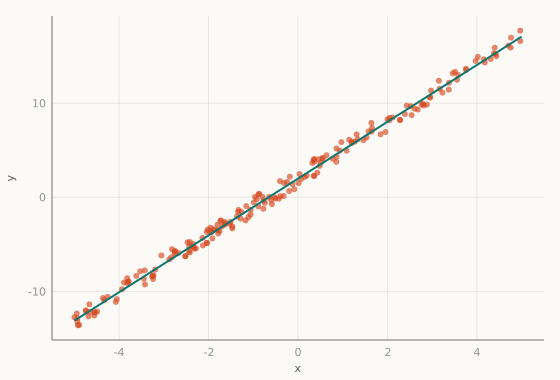
拟合结果(朱橙为数据点,青色为训练后的直线 ):
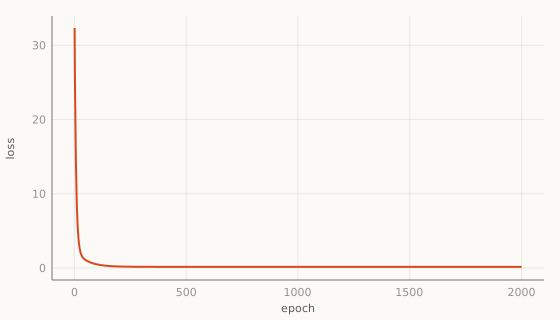
loss 收敛曲线(2000 轮全部记录):
怎么读这组数字与这两张图
- loss 先快后慢:从 一路降到 只用了一两百轮,之后几乎原地踏步。这是梯度下降的典型轨迹——离谷底越远梯度越大、步子越猛;接近谷底后梯度趋近于零,参数只做”微调”。loss.svg 里那条陡降后走平的曲线,就是”在抛物面上大步流星、然后小步挪向谷底”的足迹。
- loss 停在 0.15 附近而不是 0:数据里有人工加入的噪声 ,它本质上不可预测。 附近就是噪声的”地板”:模型学会了规律(那条直线),但不可能把噪声也预测出来——做不到,也不该做到。
- 、:非常接近造数据时用的真值 、。不完全相等正是噪声使然——如果完美等于 3 和 2,反而要怀疑它把噪声也背下来了(过拟合的雏形)。
- fit.svg 怎么看:青色直线斜穿朱橙散点带的中心,残差正负散布在直线两侧、没有系统性偏向哪一边——这正是”残差平方和最小”的肉眼版。可以顺手验证:直线在 处的高度约是 , 每加 1, 约加 3。
另外注意,本篇没有用基础篇的 Matrix:一元回归只有一个特征,用 Vec<f64> 足矣,代码更短、更聚焦梯度下降本身。等进入多元回归,把标量 换成特征向量、把 Vec 换成 Matrix,梯度公式几乎原封不动——这正是基础篇末尾 的威力。
优缺点与适用场景
照抄算法清单 1.1 的原文评价:
- 优点:可解释性强、有完整统计推断、闭式解无需迭代。
- 缺点:对多重共线性和异常值敏感,无法表达非线性关系。
- 适用场景:基线模型、需要解释系数的场景(经济学、社会科学)。
对照本篇的实验可以直观理解第一条:OLS 的每个系数都有明确含义(斜率 = 每加一单位 的变化量),而且像本篇这样有闭式解的模型甚至可以一步到位、无需训练循环;它的缺陷则要等到多元回归与多项式回归篇才会真正现身。
小结
我们走完了机器学习的完整闭环:定义损失(最小二乘)→ 求梯度(链式法则)→ 迭代优化(梯度下降)→ 在模拟数据上验证收敛,并且第一次让结果可视化。全部代码只依赖标准库。下一篇进入回归②:把标量 扩展成特征向量实现多元回归,直面两个真实问题——特征量纲悬殊时梯度下降为什么会来回震荡(特征缩放),以及学习率与正则化如何联手让模型既收敛得快又不死记硬背。