用 Rust 从头实现机器学习算法·回归④:正则化三兄弟——岭、套索与弹性网络
用 Rust 从头实现机器学习算法·回归④:正则化三兄弟——岭、套索与弹性网络
上一篇的结尾是个悬而未决的问题:M=9 的多项式在 15 个训练点上过拟合,我们只能「换个阶数重训一遍」来躲避。本篇给出正解——不换模型,给参数戴上紧箍咒。主角是正则化三兄弟:L2 的岭回归、L1 的套索,以及两者混合的弹性网络。数据沿用上一篇(同样的真值曲线、同样的 15/30 个训练/验证点、同样的 M=9 升维),让正则化的效果与上一篇的 OLS 基线直接可比。
核心思想
过拟合的本质是参数为了迁就训练集中的噪声而「走得太远」——M=9 的 |w| 膨胀到 24.5 就是证据。正则化在损失函数里加一项罚款:
控制紧箍咒的松紧: 退回 OLS; 参数全被压成 0、模型退化成「预测均值」。三种方法的区别只在罚款的形式:
- 岭回归(L2):罚 ——大系数贵,但不为零;
- 套索(L1):罚 ——费用的「棱角」让最优解恰好落在坐标轴上,部分系数精确归零,自动做特征选择;
- 弹性网络:两者各取一半,兼顾收缩与选择。
清单还给了两个高阶视角,本篇代码无法直接展示但值得记住:岭回归等价于给系数加高斯先验做 MAP 估计;套索等价于拉普拉斯先验——正则化参数 就是先验强度。这扇门的背后是整个贝叶斯世界(下一篇推开它)。
数学:闭式解、软阈值与矩阵求逆
先把缩放约定钉死。代码的数据项都是 ,其梯度为 。惩罚项的常数可以吸收进 ,但跨模型、跨库比较时必须把完整目标写出来,不能只比较 数字。
岭回归:闭式解与截距例外
ridge_closed_form 等价于最小化
对斜率求导并置零,乘以 后得到
其中 ,第 0 项截距不罚。代码里的 lambda 直接加到 XᵀX 对角线,因此它对应这里的 ;也就是说,若把代码公式写成 ,就已经采用了未除以 的岭目标。两种写法等价,关键是不要混用。
含非零截距列且 时,斜率方向的二次型被加上正数,截距方向又由全 1 列支撑,因此矩阵可逆。这缓解了高阶多项式的共线性,但生产代码仍通常选择分解线性方程,而不是显式形成逆矩阵。
高斯-约当:一次主元交换的完整过程
inverse 构造增广矩阵 ,通过行变换化为 。部分主元策略先选当前列绝对值最大的元素。以
为例,首列不能直接以 0 为主元,先交换两行:
第二行除以 2,再令第一行减去 3 倍新第二行:
所以 ,可直接验证 。代码的 pivot 搜索、aug.data.swap、主元行归一化和其他行消元正对应这四步;主元绝对值小于 时返回 None,避免输出看似正常实则无意义的数。
套索:软阈值为什么会精确归零
lasso_fit 对应目标
L1 在 0 点不可微,因此先做普通最小二乘梯度步 ,再施加软阈值
取阈值 ,三个代表性输入完整算出:
中间的小系数被精确归零,大系数只收缩不翻转符号。截距 j == 0 只走普通梯度步,不进入 soft_threshold。
弹性网络:代码中的对称混合
enet_fit 的数据梯度同样是 ,每个斜率额外加 的 L2 梯度,再用阈值 做 L1 近端步。它对应
所以”弹性网络各取一半”在这篇代码里是 L1 与 L2 惩罚权重都为 ,不是把 lasso_fit 和 ridge_closed_form 的 原封不动拼起来。
数学 ↔ 代码对应表
| 数学 | Rust 实现 |
|---|---|
ridge_closed_form 对 j in 1..cols 加对角元 | |
Matrix::inverse 的增广矩阵与行消元 | |
| 部分主元选择 | 搜索 pivot 并交换增广行 |
soft_threshold(v,t) | |
| 截距不罚 | 三个模型中的 j == 0 分支 |
| L2 进梯度、L1 进近端 | enet_fit 的 step += ... 与软阈值 |
scikit-learn 对照:alpha 不是脱离目标函数的数字
Ridge(alpha=α)最小化 ;本篇闭式代码若采用未缩放目标, 与代码对角线上的 对齐。Lasso(alpha=α)最小化 ,与lasso_fit的写法直接对齐,但库通常用坐标下降而非近端梯度。ElasticNet(alpha=α,l1_ratio=ρ)的惩罚为 ;本篇enet_fit对应 。
库默认通常不惩罚单独拟合的截距,并提供收敛容差、最大迭代数和成熟的病态处理。复现实验时应先统一特征标准化、截距约定与目标缩放,再比较系数路径。
Rust 实现
// src/main.rs(段一:Matrix 含求逆、三个正则化模型与三个实验)
// 回归④:正则化三兄弟——岭回归、套索与弹性网络
// 单文件、仅标准库。绘图器与 01~05 篇内联的是同一份实现。

// ===================== Matrix(含高斯-约当求逆) =====================

#[derive(Debug, Clone)]
struct Matrix {
    data: Vec<f64>,
    rows: usize,
    cols: usize,
}

impl Matrix {
    fn from_vec(data: Vec<f64>, rows: usize, cols: usize) -> Matrix {
        assert_eq!(data.len(), rows * cols, "数据长度与矩阵形状不一致");
        Matrix { data, rows, cols }
    }

    fn zeros(rows: usize, cols: usize) -> Matrix {
        Matrix { data: vec![0.0; rows * cols], rows, cols }
    }

    /// 单位矩阵(求逆测试与岭回归惩罚项的构造块)。
    #[allow(dead_code)] // 主流程用「对角线 += λ」的等价写法,本方法由单元测试覆盖
    fn identity(n: usize) -> Matrix {
        let mut out = Matrix::zeros(n, n);
        for i in 0..n {
            out.data[i * n + i] = 1.0;
        }
        out
    }

    fn shape(&self) -> (usize, usize) {
        (self.rows, self.cols)
    }

    fn get(&self, i: usize, j: usize) -> f64 {
        self.data[i * self.cols + j]
    }

    fn matmul(&self, other: &Matrix) -> Matrix {
        assert_eq!(self.cols, other.rows, "内维不一致:{:?} 无法乘 {:?}", self.shape(), other.shape());
        let mut out = Matrix::zeros(self.rows, other.cols);
        for i in 0..self.rows {
            for j in 0..other.cols {
                let mut sum = 0.0;
                for k in 0..self.cols {
                    sum += self.get(i, k) * other.get(k, j);
                }
                out.data[i * out.cols + j] = sum;
            }
        }
        out
    }

    fn transpose(&self) -> Matrix {
        let mut out = Matrix::zeros(self.cols, self.rows);
        for i in 0..self.rows {
            for j in 0..self.cols {
                out.data[j * self.rows + i] = self.get(i, j);
            }
        }
        out
    }

    fn sub(&self, other: &Matrix) -> Matrix {
        assert_eq!(self.shape(), other.shape(), "形状不一致,无法相减");
        let mut out = Matrix::zeros(self.rows, self.cols);
        for i in 0..self.data.len() {
            out.data[i] = self.data[i] - other.data[i];
        }
        out
    }

    /// 高斯-约当消元求逆(带部分主元)。奇异矩阵返回 None。
    fn inverse(&self) -> Option<Matrix> {
        assert_eq!(self.rows, self.cols, "只有方阵才能求逆");
        let n = self.rows;
        // 增广矩阵 [A | I]
        let mut aug = Matrix::zeros(n, 2 * n);
        for i in 0..n {
            for j in 0..n {
                aug.data[i * 2 * n + j] = self.get(i, j);
            }
            aug.data[i * 2 * n + n + i] = 1.0;
        }
        for col in 0..n {
            // 部分主元:找当前列绝对值最大的行,避免用小数做除数
            let mut pivot = col;
            for r in col + 1..n {
                if aug.get(r, col).abs() > aug.get(pivot, col).abs() {
                    pivot = r;
                }
            }
            if aug.get(pivot, col).abs() < 1e-12 {
                return None; // 奇异矩阵
            }
            if pivot != col {
                for j in 0..2 * n {
                    aug.data.swap(col * 2 * n + j, pivot * 2 * n + j);
                }
            }
            // 归一化主元行
            let p = aug.get(col, col);
            for j in 0..2 * n {
                aug.data[col * 2 * n + j] /= p;
            }
            // 消元:其他行的当前列清零
            for r in 0..n {
                if r == col {
                    continue;
                }
                let f = aug.get(r, col);
                if f == 0.0 {
                    continue;
                }
                for j in 0..2 * n {
                    aug.data[r * 2 * n + j] -= f * aug.get(col, j);
                }
            }
        }
        let mut inv = Matrix::zeros(n, n);
        for i in 0..n {
            for j in 0..n {
                inv.data[i * n + j] = aug.get(i, n + j);
            }
        }
        Some(inv)
    }
}

// ===================== xorshift64 伪随机数(沿用 03 篇) =====================

struct XorShift(u64);

impl XorShift {
    fn new(seed: u64) -> Self {
        assert!(seed != 0, "种子不能为 0");
        XorShift(seed)
    }

    fn next_u64(&mut self) -> u64 {
        let mut x = self.0;
        x ^= x << 13;
        x ^= x >> 7;
        x ^= x << 17;
        self.0 = x;
        x
    }

    fn next_f64(&mut self) -> f64 {
        (self.next_u64() >> 11) as f64 / (1u64 << 53) as f64
    }
}

// ===================== 特征工程与三个正则化模型 =====================

/// 真值曲线:与 05 篇相同的三次曲线,直接复用其数据设定。
fn truth(x: f64) -> f64 {
    0.15 * x * x * x - x * x + 2.0 * x + 3.0
}

/// 一列原始 x 升维成设计矩阵 n×(m+1):第 j 列是 x 的 j 次幂,第 0 列恒为 1。
fn design(xs: &[f64], m: usize) -> Matrix {
    let n = xs.len();
    let mut data = vec![0.0; n * (m + 1)];
    for (i, x) in xs.iter().enumerate() {
        let mut v = 1.0;
        for j in 0..=m {
            data[i * (m + 1) + j] = v;
            v *= x;
        }
    }
    Matrix::from_vec(data, n, m + 1)
}

/// 按训练集各列的 μ/σ 标准化(第 0 列截距项除外),返回 (标准化矩阵, mu, sigma)。
fn standardize(train: &Matrix) -> (Matrix, Vec<f64>, Vec<f64>) {
    let (n, cols) = train.shape();
    let mut mu = vec![0.0; cols];
    let mut sigma = vec![0.0; cols];
    for j in 0..cols {
        if j == 0 {
            continue;
        }
        let col: Vec<f64> = (0..n).map(|i| train.get(i, j)).collect();
        mu[j] = col.iter().sum::<f64>() / n as f64;
        let var = col.iter().map(|v| (v - mu[j]).powi(2)).sum::<f64>() / n as f64;
        sigma[j] = var.sqrt();
        if sigma[j] < 1e-12 {
            sigma[j] = 1.0;
        }
    }
    let mut out = train.clone();
    for j in 1..cols {
        for i in 0..n {
            out.data[i * cols + j] = (train.get(i, j) - mu[j]) / sigma[j];
        }
    }
    (out, mu, sigma)
}

/// 预测:原始特征升维 → 标准化 → 与 w 点积。
fn predict(x: f64, w: &[f64], mu: &[f64], sigma: &[f64]) -> f64 {
    let mut v = 1.0;
    let mut yhat = w[0];
    for j in 1..w.len() {
        v *= x;
        yhat += w[j] * (v - mu[j]) / sigma[j];
    }
    yhat
}

fn mse(yhats: &[f64], ys: &[f64]) -> f64 {
    let n = ys.len();
    let se: f64 = yhats.iter().zip(ys.iter()).map(|(a, b)| (a - b).powi(2)).sum();
    se / n as f64
}

/// 岭回归闭式解:w = (XᵀX + λI′)⁻¹ Xᵀ y。
/// I′ 表示截距项(第 0 列)不加惩罚——正则化只管斜率,不管整体平移。
fn ridge_closed_form(x: &Matrix, ys: &[f64], lambda: f64) -> Option<Vec<f64>> {
    let (n, cols) = x.shape();
    let xt = x.transpose();
    let mut a = xt.matmul(x); // XᵀX,cols×cols
    for j in 1..cols {
        a.data[j * cols + j] += lambda;
    }
    let a_inv = a.inverse()?; // 奇异时向上传播 None
    let b = xt.matmul(&Matrix::from_vec(ys.to_vec(), n, 1)); // Xᵀy
    let w = a_inv.matmul(&b);
    Some(w.data)
}

/// 软阈值:近端算子,套索的「归零开关」。
fn soft_threshold(v: f64, t: f64) -> f64 {
    v.signum() * (v.abs() - t).max(0.0)
}

/// 套索(L1):梯度下降 + 每步对斜率项做软阈值。
fn lasso_fit(x: &Matrix, ys: &[f64], lr: f64, epochs: usize, lambda: f64) -> Vec<f64> {
    let (n, cols) = x.shape();
    let mut w = Matrix::from_vec(vec![0.0; cols], cols, 1);
    let y = Matrix::from_vec(ys.to_vec(), n, 1);
    for _ in 0..epochs {
        let e = x.matmul(&w).sub(&y);
        let grad = x.transpose().matmul(&e);
        for j in 0..cols {
            let step = lr * grad.data[j] / n as f64;
            if j == 0 {
                w.data[j] -= step; // 截距不惩罚
            } else {
                w.data[j] = soft_threshold(w.data[j] - step, lr * lambda);
            }
        }
    }
    w.data
}

/// 弹性网络:L1 近端 + L2 梯度(演示 α=0.5 的对称混合)。
fn enet_fit(x: &Matrix, ys: &[f64], lr: f64, epochs: usize, lambda: f64) -> Vec<f64> {
    let (n, cols) = x.shape();
    let mut w = Matrix::from_vec(vec![0.0; cols], cols, 1);
    let y = Matrix::from_vec(ys.to_vec(), n, 1);
    for _ in 0..epochs {
        let e = x.matmul(&w).sub(&y);
        let grad = x.transpose().matmul(&e);
        for j in 0..cols {
            let mut step = lr * grad.data[j] / n as f64;
            if j > 0 {
                step += lr * lambda * w.data[j]; // L2 部分进梯度
                w.data[j] = soft_threshold(w.data[j] - step, lr * lambda / 2.0); // L1 部分进近端
            } else {
                w.data[j] -= step;
            }
        }
    }
    w.data
}

/// 对数等距网格:λ 从 1e-4 到 1e3 共 13 档。
fn lambda_grid() -> Vec<f64> {
    (0..13).map(|i| 10f64.powi(i as i32 - 4)).collect()
}

/// 半对数网格:10^(-4 + 0.5k),k = 0..=12 → 1e-4 .. 1e2,适合看套索的渐进稀疏化。
fn half_decade_grid() -> Vec<f64> {
    (0..13).map(|k| 10f64.powf(k as f64 * 0.5 - 4.0)).collect()
}

/// λ 的紧凑打印:大数保留整数,小数用科学计数。
fn fmt_lambda(lam: f64) -> String {
    if lam >= 0.01 {
        format!("{lam:.2}")
    } else {
        format!("{lam:.0e}")
    }
}

fn main() {
    let out_dir = "../../../frontend/public/images/series/rust-ml-06-regularization";
    std::fs::create_dir_all(out_dir).expect("创建输出目录失败");

    // ---- 1. 数据沿用 05 篇设定:15 训练 + 30 验证,M = 9 升维 ----
    let mut rng = XorShift::new(42);
    let sample = |rng: &mut XorShift, n: usize| -> (Vec<f64>, Vec<f64>) {
        let mut xs = Vec::with_capacity(n);
        let mut ys = Vec::with_capacity(n);
        for _ in 0..n {
            let x = rng.next_f64() * 5.0;
            let eps = (rng.next_f64() - 0.5) * 3.0;
            xs.push(x);
            ys.push(truth(x) + eps);
        }
        (xs, ys)
    };
    let (xtr, ytr) = sample(&mut rng, 15);
    let (xva, yva) = sample(&mut rng, 30);
    let m = 9usize;
    let xmat = design(&xtr, m);
    let (xstd, mu, sigma) = standardize(&xmat);

    let pred_all = |w: &[f64]| {
        let tr = mse(&(0..xtr.len()).map(|i| predict(xtr[i], w, &mu, &sigma)).collect::<Vec<_>>(), &ytr);
        let va = mse(&(0..xva.len()).map(|i| predict(xva[i], w, &mu, &sigma)).collect::<Vec<_>>(), &yva);
        (tr, va)
    };

    // ---- 2. 基线:λ = 0(OLS)与上一篇的 GD 无惩罚解一致 ----
    let w_ols = ridge_closed_form(&xstd, &ytr, 0.0).expect("λ=0 时 XᵀX 奇异——这正是需要正则化的证据");
    let (tr0, va0) = pred_all(&w_ols);
    println!("OLS (λ=0):      train MSE = {:>9.4} | val MSE = {:>9.4}", tr0, va0);

    // ---- 3. 实验一:岭回归 λ 扫描(闭式解) ----
    println!("\n[岭回归]  λ        log10λ   train MSE    val MSE    |w|");
    let mut ridge_tr = Vec::new();
    let mut ridge_va = Vec::new();
    let mut best = (0.0f64, f64::INFINITY);
    for &lam in &lambda_grid() {
        let w = ridge_closed_form(&xstd, &ytr, lam).expect("XᵀX+λI 必可逆");
        let (tr, va) = pred_all(&w);
        let norm: f64 = w.iter().skip(1).map(|v| v * v).sum::<f64>().sqrt();
        println!("          {:>10} {:>8.2} {:>12.4} {:>10.4} {:>8.4}", fmt_lambda(lam), lam.log10(), tr, va, norm);
        ridge_tr.push((lam.log10(), tr));
        ridge_va.push((lam.log10(), va));
        if va < best.1 {
            best = (lam, va);
        }
    }
    let ridge_best = best;
    println!("岭回归最优: λ = {}(val MSE = {:.4})", fmt_lambda(ridge_best.0), ridge_best.1);

    // ---- 4. 实验二:套索系数路径(λ 增大,系数逐个归零) ----
    let lasso_grid = half_decade_grid();
    println!("\n[套索]    λ        log10λ   非零系数   val MSE");
    let mut paths: Vec<Vec<(f64, f64)>> = vec![Vec::new(); m + 1];
    let mut lasso_va = Vec::new();
    let mut best_lasso = (0.0f64, f64::INFINITY);
    for &lam in &lasso_grid {
        let w = lasso_fit(&xstd, &ytr, 0.05, 4000, lam);
        let (_, va) = pred_all(&w);
        let nonzero = w.iter().skip(1).filter(|v| v.abs() > 1e-6).count();
        println!("          {:>10} {:>8.2} {:>8} {:>12.4}", fmt_lambda(lam), lam.log10(), nonzero, va);
        lasso_va.push((lam.log10(), va));
        for (j, path) in paths.iter_mut().enumerate() {
            path.push((lam.log10(), w[j]));
        }
        if va < best_lasso.1 {
            best_lasso = (lam, va);
        }
    }
    println!("套索最优: λ = {:.4}(val MSE = {:.4})", best_lasso.0, best_lasso.1);

    // ---- 5. 实验三:三种方法同图对比(val MSE vs λ) ----
    println!("\n[弹性网络] λ        log10λ   val MSE");
    let enet_grid = half_decade_grid();
    let mut enet_va = Vec::new();
    let mut best_enet = (0.0f64, f64::INFINITY);
    for &lam in &enet_grid {
        let w = enet_fit(&xstd, &ytr, 0.05, 4000, lam);
        let (_, va) = pred_all(&w);
        println!("          {:>10} {:>8.2} {:>12.4}", fmt_lambda(lam), lam.log10(), va);
        enet_va.push((lam.log10(), va));
        if va < best_enet.1 {
            best_enet = (lam, va);
        }
    }
    println!("弹性网络最优: λ = {}(val MSE = {:.4})", fmt_lambda(best_enet.0), best_enet.1);

    // ---- 6. 画图 ----
    let ymax = ridge_tr.iter().chain(&ridge_va).map(|p| p.1).fold(0.0f64, f64::max) * 1.1;
    let mut c = Canvas::new(560.0, 380.0, -4.0, 3.0, 0.0, ymax);
    c.axes("log10 λ", "MSE");
    c.polyline(&ridge_tr, PALETTE[0], 2.0);
    c.polyline(&ridge_va, PALETTE[1], 2.0);
    c.dots(&[(ridge_best.0.log10(), ridge_best.1)], PALETTE[2], 5.0);
    c.legend(&[("train", PALETTE[0]), ("val", PALETTE[1]), ("best", PALETTE[2])]);
    let p1 = format!("{out_dir}/ridge-lambda.svg");
    c.save(&p1);

    let mut c = Canvas::new(560.0, 380.0, -4.0, 2.0, -2.5, 2.5);
    c.axes("log10 λ", "系数值 w_j");
    for (j, path) in paths.iter().enumerate() {
        c.polyline(path, PALETTE[j % PALETTE.len()], 1.4);
    }
    let p2 = format!("{out_dir}/lasso-path.svg");
    c.save(&p2);

    let ymax = ridge_va.iter().chain(&lasso_va).chain(&enet_va).map(|p| p.1).fold(0.0f64, f64::max) * 1.1;
    let mut c = Canvas::new(560.0, 380.0, -4.0, 2.0, 0.0, ymax);
    c.axes("log10 λ", "val MSE");
    c.polyline(&ridge_va, PALETTE[0], 2.0);
    c.polyline(&lasso_va, PALETTE[1], 2.0);
    c.polyline(&enet_va, PALETTE[3], 2.0);
    c.legend(&[("ridge", PALETTE[0]), ("lasso", PALETTE[1]), ("enet", PALETTE[3])]);
    let p3 = format!("{out_dir}/methods-compare.svg");
    c.save(&p3);

    println!("\n图已写入:{p1}、{p2}、{p3}");
}
段一实现要点:
inverse是本篇唯一的”新数学”:增广矩阵 原地做高斯-约当,部分主元用swap交换整行;主元绝对值小于 判定奇异,返回None。它是全系列第一个返回Option的函数——用法在语法角展开。ridge_closed_form直接翻译公式: 对角线从第 1 列起加 ,求逆后乘 。三行矩阵运算对应三行数学。soft_threshold一行实现 ,注意f64::signum在 时返回 0,恰好安全。lasso_fit与enet_fit共用骨架:矩阵化梯度步 + 按列区分截距(第 0 列永远只走梯度)。
// src/main.rs 段二:迷你 SVG 绘图器(与系列前篇同一份实现)
use std::fmt::Write as _;

// ===================== 迷你 SVG 绘图器(与系列前篇一致) =====================

/// 系列默认配色:朱橙 / 青绿 / 蓝 / 琥珀(取自站点设计令牌)。
const PALETTE: [&str; 4] = ["#d6491f", "#0f766e", "#2563eb", "#d97706"];

struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    /// 图例:右上角依次画「色线 + 文字」。
    fn legend(&mut self, entries: &[(&str, &str)]) {
        let sample_w = 22.0;
        let line_h = 18.0;
        let x0 = self.w - self.pad_r - 78.0;
        let x_text = x0 + sample_w + 6.0;
        for (i, (label, color)) in entries.iter().enumerate() {
            let y = self.pad_t + 14.0 + i as f64 * line_h;
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{:.1}" y2="{y:.1}" stroke="{color}" stroke-width="2.5"/>"##,
                x0 + sample_w
            );
            let _ = write!(
                self.body,
                r##"<text x="{x_text:.1}" y="{:.1}" fill="#16161d" fill-opacity="0.7">{label}</text>"##,
                y + 4.0
            );
        }
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}
// src/main.rs 末尾:单元测试(cargo test 运行)
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn inverse_times_self_is_identity() {
// 固定小矩阵,避免引入随机性
let a = Matrix::from_vec(vec![4.0, 7.0, 2.0, 6.0], 2, 2);
let inv = a.inverse().expect("非奇异矩阵应有逆");
let prod = a.matmul(&inv);
let eye = Matrix::identity(2);
for i in 0..2 {
for j in 0..2 {
assert!((prod.get(i, j) - eye.get(i, j)).abs() < 1e-9);
}
}
}
#[test]
fn inverse_detects_singular() {
// 第 2 行 = 第 1 行 × 2,行列式为 0
let a = Matrix::from_vec(vec![1.0, 2.0, 2.0, 4.0], 2, 2);
assert!(a.inverse().is_none());
}
#[test]
fn soft_threshold_shrinks_and_zeros() {
assert_eq!(soft_threshold(3.0, 1.0), 2.0);
assert_eq!(soft_threshold(-3.0, 1.0), -2.0);
assert_eq!(soft_threshold(0.5, 1.0), 0.0);
}
#[test]
fn ridge_shrinks_coefficients() {
let x = design(&[1.0, 2.0, 3.0, 4.0, 5.0], 3);
let (xs, _, _) = standardize(&x);
let y = vec![1.0, 2.0, 1.5, 3.0, 4.0];
let w0 = ridge_closed_form(&xs, &y, 0.0).unwrap();
let w1 = ridge_closed_form(&xs, &y, 100.0).unwrap();
let n0: f64 = w0.iter().skip(1).map(|v| v.abs()).sum();
let n1: f64 = w1.iter().skip(1).map(|v| v.abs()).sum();
assert!(n1 < n0, "λ 增大应收缩系数:{} !< {}", n1, n0);
}
}Rust 语法角:Option、? 与错误处理
inverse 可能失败(奇异矩阵),Rust 要求调用者显式处理这个可能性,武器是 Option<T>:它有 Some(x) 与 None 两个变体,类型系统强迫你考虑两者。代码里出现了三种处理方式,由内向外层递进:
ridge_closed_form里a.inverse()?——?表示”是 None 就直接把 None 返回给调用方”,错误逐层自动上抛;- 主流程里
.expect("...")—— 我们证明了 必可逆,失败只可能是 bug,panic 是对的; - 单元测试里
assert!(a.inverse().is_none())—— 反过来断言”这里必须失败”。
Python 的对应物是返回 None 或抛异常,但没有任何机制强迫调用者检查:忘记 if x is None 要等到 AttributeError 才在运行时发现。Rust 把”这个函数可能失败”写进了类型签名。详见《Rust 程序设计语言》ch06-01(Option)与 ch09-02(? 操作符)。
运行结果
cargo test(4 个用例:逆矩阵乘回原矩阵得单位阵、奇异矩阵检出、软阈值行为、λ 增大必收缩系数)全部通过后,cargo run:
OLS (λ=0):      train MSE =    0.1121 | val MSE = 35230.1419

[岭回归]  λ        log10λ   train MSE    val MSE    |w|
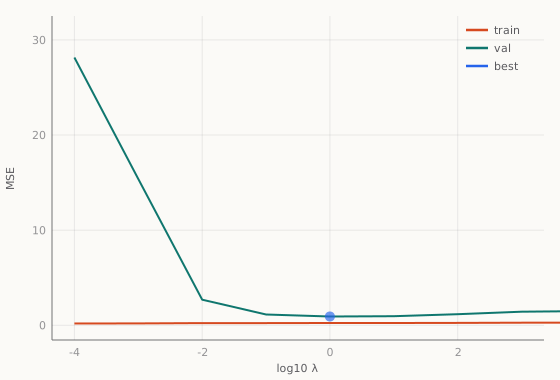
                1e-4    -4.00       0.1910    28.1524  24.4552
                1e-3    -3.00       0.2017    15.3746  12.3966
                0.01    -2.00       0.2256     2.6864   2.3965
                0.10    -1.00       0.2329     1.1291   0.3958
                1.00     0.00       0.2351     0.9192   0.1594
               10.00     1.00       0.2388     0.9526   0.0817
              100.00     2.00       0.2501     1.1608   0.0377
             1000.00     3.00       0.2726     1.4228   0.0074
            10000.00     4.00       0.2795     1.4901   0.0008
           100000.00     5.00       0.2803     1.4979   0.0001
          1000000.00     6.00       0.2804     1.4986   0.0000
          10000000.00     7.00       0.2804     1.4987   0.0000
          100000000.00     8.00       0.2804     1.4987   0.0000
岭回归最优: λ = 1.00(val MSE = 0.9192)

[套索]    λ        log10λ   非零系数   val MSE
                1e-4    -4.00        9       1.2534
                3e-4    -3.50        9       1.2158
                1e-3    -3.00        6       1.0957
                3e-3    -2.50        2       0.9640
                0.01    -2.00        2       0.9133
                0.03    -1.50        1       0.8981
                0.10    -1.00        1       0.9856
                0.32    -0.50        0       1.4987
                1.00     0.00        0       1.4987
                3.16     0.50        0       1.4987
               10.00     1.00        0       1.4987
               31.62     1.50        0       1.4987
              100.00     2.00        0       1.4987
套索最优: λ = 0.0316(val MSE = 0.8981)

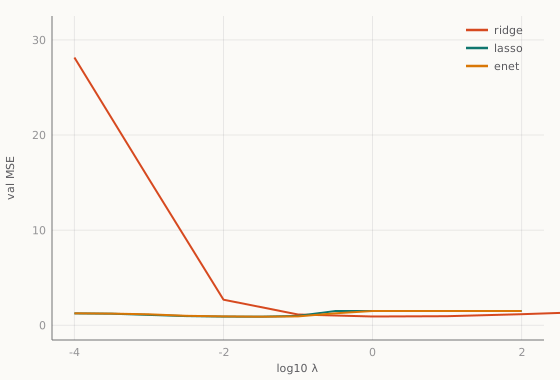
[弹性网络] λ        log10λ   val MSE
                1e-4    -4.00       1.2580
                3e-4    -3.50       1.2308
                1e-3    -3.00       1.1501
                3e-3    -2.50       0.9978
                0.01    -2.00       0.9334
                0.03    -1.50       0.9002
                0.10    -1.00       0.9335
                0.32    -0.50       1.2567
                1.00     0.00       1.4987
                3.16     0.50       1.4987
               10.00     1.00       1.4987
               31.62     1.50       1.4987
              100.00     2.00       1.4987
弹性网络最优: λ = 0.03(val MSE = 0.9002)

图已写入:../../../frontend/public/images/series/rust-ml-06-regularization/ridge-lambda.svg、../../../frontend/public/images/series/rust-ml-06-regularization/lasso-path.svg、../../../frontend/public/images/series/rust-ml-06-regularization/methods-compare.svg
三张图:
怎么读这些数字和图
- OLS 基行先给你一个惊吓:λ=0 的闭式解 train MSE 只有 0.1121(比上一篇 GD 的 0.2324 还低),但 val MSE 高达 35230。这不是 bug:病态的 被精确求逆后,把训练噪声放大了一万多倍。05 篇 GD 之所以”没事”,是有限步数的隐性早停替我们挡了刀。λ 只要加到 1e-4,val 立刻从 35230 回落到 28——正则化首先是数值稳定器,其次才是防过拟合。
- |w| 列是紧箍咒的直读表:24.46 → 0.16(λ=1)→ 0.00。参数被连续压缩,没有跳变——L2 收缩的特点是”人人有份,只缩不死”。
- 岭回归的 val 是标准 U 形:谷底 λ=1(0.9192)。左端 λ 太小数值爆炸,右端 λ 太大模型退化成预测均值(1.4987,正是 M=0 的 val)。
- 套索路径展示了”选择”:非零系数 9 → 6 → 2 → 1 → 0 逐级递减,val 谷底 0.8981 还略优于岭回归——它用 1 个非零特征就达到了同等预测力。lasso-path.svg 里能看到系数折线逐条趴到零线上。
- 弹性网络居中(谷底 0.9002),与两者同图可见它兼收并蓄——本例数据太小,优势不明显;它真正的主场是清单指出的 p ≫ n 或特征高度相关的场景。
- 横向对比回到清单的三句话:岭回归稳定、系数都保留,套索稀疏、自动选特征,弹性网络在相关特征成群时更稳。
优缺点与适用场景
(抄清单 1.6–1.8 原文)
- 岭回归:稳定、系数都保留(只是缩小)、适合共线性强的数据;缺点是不能做特征选择(系数不会精确为 0)。λ→0 退化为 OLS,λ→∞ 系数趋近 0。
- 套索:自动特征选择、模型稀疏、可解释性好;缺点是共线性强的相关特征中会随机选一个、把其他压成 0(不稳定),多选特征时性能可能不如岭回归。无闭式解,需坐标下降(本文用等价的近端梯度)。
- 弹性网络:结合了 Lasso 的特征选择能力和 Ridge 的稳定性;当特征数远大于样本数(p ≫ n)或特征高度相关时优于单独使用 L1 或 L2。高维数据(基因组学、文本特征)的默认正则化选择。
小结
同一个 M=9 过拟合问题,三兄弟给出三种性格的答案:岭把系数均匀压小(闭式解一步到位),套索把不重要的系数归零(软阈值逐个劝退),弹性网络两头下注。λ 扫描曲线统一呈 U 形——正则化强度的选择本身又成了新的超参数,工程上靠交叉验证定夺。但 λ 到底”意味着什么”,我们已经从贝叶斯视角瞟到了答案:它是先验的强度。下一篇回归⑤:贝叶斯回归——把参数当作随机变量,让模型自己说出”我有多确定”。