用 Rust 从头实现机器学习算法·分类④:决策树——用熵的尺子递归切分世界
用 Rust 从头实现机器学习算法·分类④:决策树——用熵的尺子递归切分世界
前三篇分类器各有前提:逻辑回归要线性,kNN 要距离有意义,朴素贝叶斯要条件独立。决策树的前提最少——只需特征能排序。它用一连串 if-then 规则把特征空间切成矩形区域,是清单里”可解释性最强”的算法:训练完不是一组权重,而是一套可以直接念给业务方听的判定规则。
核心思想
学习的关键问题只有一个:每一步选什么特征、按什么阈值切。答案是用一把”纯度”尺子量化每个候选切分的好坏。我们实现 CART 算法采用的 Gini 不纯度:
是节点内第 类样本占比。全同类时 Gini = 0(最纯),两类各半时 = 0.5(最乱)。对每个特征的每个候选阈值(排序后相邻不同值的中点),计算加权 Gini,选下降最多的一刀。然后递归:对左右子集重复同样的问题,直到节点全同类或触发停止条件。清单还提到了另外两把尺子:ID3 的信息增益(熵的差)与 C4.5 的信息增益率——思想同构,刻度不同。
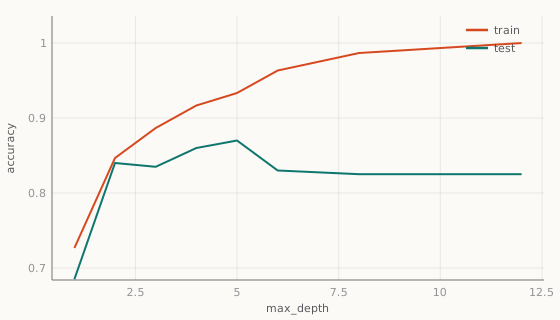
停止条件就是预剪枝:限深度、限最小分裂样本数。不剪枝的树会一直切到每个叶子只剩一两个样本——训练集满分,测试集翻车(后文的深度扫描会现场演示)。
数学:一步切分的评分与递归边界
二分类节点中正类比例为 ,Gini 不纯度为
候选切分 把 个样本分成 两份,评分与增益为
增益越大,这刀越能让子节点纯净。空子集的 gini 返回 0 只是实现兜底,候选阈值来自不同取值的中点,正常最优切分不应把全部样本分到同一侧。
两刀候选的完整手算
设父节点标签为 ,则 ,。
- 理想切分:左侧 、右侧 ,两边 Gini 都为 0,故 。
- 噪声切分:左侧 、右侧 。左侧 ,;右侧 。因此
两刀都有效,贪心算法选增益 0.5 的理想切分。可是当真实规则带有标签噪声时,某个小增益切分也可能暂时排名第一;没有深度或样本数约束,递归就会继续为少数样本造规则。
best_split 对每个特征排序,在相邻不同值 间取 。中点两侧不会插入训练值,所以同一对相邻值之间的任何阈值训练评分相同;取中点是确定且简洁的代表。实现要求 drop > 1e-12,否则返回 None 并让节点成为多数类叶。
递归何时停止,预测如何走树
build_tree 的停止路径有三类:节点全同类;达到 max_depth 或样本数不足 min_samples;找不到正增益切分。分支节点保存 feature/threshold/gini_drop 和左右 Box<TreeNode>,预测时只需重复比较 ,直到叶节点。
预剪枝限制树继续生长,后剪枝则先长再删;本篇实现前者。深度扫描展示的不是”越深模型越错”的定律,而是容量增加后训练误差与验证误差可以分道扬镳。信息熵 与 Gini 的数值不同,但都在纯节点取 0、混合节点更大,选择时应通过验证而非凭名称。
数学 ↔ 代码对应表
| 数学 | Rust 实现 |
|---|---|
gini(ys) | |
| 左右加权 Gini | split_gini |
| 候选阈值 | best_split 的排序与 t |
parent - score | |
| 预剪枝与叶节点回退 | build_tree 的两组提前返回 |
| 沿规则预测 | predict 对 TreeNode 的递归匹配 |
scikit-learn 对照:同为 CART,默认值也会改变树
DecisionTreeClassifier 使用优化过的 CART 实现,criterion='gini' 与本篇一致,也可切换 entropy/log_loss。max_depth、min_samples_split、min_samples_leaf 分别约束不同层面;本篇只有一个统一的 min_samples,不能直接当作库中两个参数的合并等价物。
库的划分搜索、类别权重、缺失值策略和随机特征选项更丰富。比较树形时应固定随机状态、候选准则与全部停止参数;比较小增益切分时还要注意浮点容差,否则一个看似无关紧要的默认差异就可能改变整棵子树。
Rust 实现
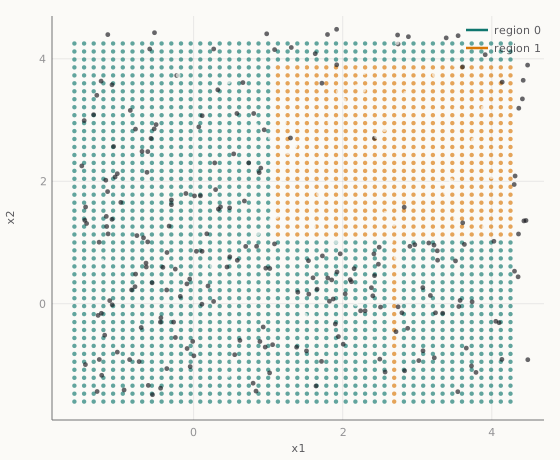
本篇的数据是轴平行矩形规则:类 1 = 落在 矩形内(10% 标签翻转当噪声)。矩形边界与树的切分方式严丝合缝——这是决策树的主场。
// src/main.rs(段一:CART 决策树与实验主程序)
// 分类④:决策树——用熵的尺子递归切分世界
// 单文件、仅标准库。绘图器与系列前篇内联的是同一份实现。
// ===================== xorshift64(沿用 03 篇) =====================
struct XorShift(u64);
impl XorShift {
fn new(seed: u64) -> Self {
assert!(seed != 0, "种子不能为 0");
XorShift(seed)
}
fn next_u64(&mut self) -> u64 {
let mut x = self.0;
x ^= x << 13;
x ^= x >> 7;
x ^= x << 17;
self.0 = x;
x
}
fn next_f64(&mut self) -> f64 {
(self.next_u64() >> 11) as f64 / (1u64 << 53) as f64
}
}
// ===================== CART 决策树(Gini 不纯度) =====================
/// 树节点:叶子存类别,内节点存切分特征与阈值。
/// Box 让左右子树"拥有"在堆上——递归数据结构的 Rust 表达方式。
enum TreeNode {
Leaf(f64),
Branch {
feature: usize,
threshold: f64,
gini_drop: f64,
left: Box<TreeNode>,
right: Box<TreeNode>,
},
}
/// Gini 不纯度:1 − Σ pₖ²。越纯越小,全同类时为 0。
fn gini(ys: &[f64]) -> f64 {
if ys.is_empty() {
return 0.0;
}
let p1 = ys.iter().sum::<f64>() / ys.len() as f64;
1.0 - p1.powi(2) - (1.0 - p1).powi(2)
}
fn majority(ys: &[f64]) -> f64 {
let ones = ys.iter().filter(|&&y| y > 0.5).count();
if ones * 2 >= ys.len() { 1.0 } else { 0.0 }
}
/// 在 (feature, threshold) 处切分后的加权 Gini。
fn split_gini(xs: &[(f64, f64)], ys: &[f64], feature: usize, threshold: f64) -> f64 {
let mut left = Vec::new();
let mut right = Vec::new();
for (x, y) in xs.iter().zip(ys.iter()) {
let v = if feature == 0 { x.0 } else { x.1 };
if v <= threshold {
left.push(*y);
} else {
right.push(*y);
}
}
let n = ys.len() as f64;
left.len() as f64 / n * gini(&left) + right.len() as f64 / n * gini(&right)
}
/// 贪心最优切分:对每个特征的候选阈值(排序后相邻中点)逐一评分。
fn best_split(xs: &[(f64, f64)], ys: &[f64]) -> Option<(usize, f64, f64)> {
let parent = gini(ys);
let mut best: Option<(usize, f64, f64)> = None; // (feature, threshold, gini_drop)
for feature in 0..2 {
let mut order: Vec<usize> = (0..xs.len()).collect();
order.sort_by(|&a, &b| {
let (va, vb) = (if feature == 0 { xs[a].0 } else { xs[a].1 }, if feature == 0 { xs[b].0 } else { xs[b].1 });
va.partial_cmp(&vb).unwrap_or(std::cmp::Ordering::Equal)
});
for w in 0..order.len() - 1 {
let a = order[w];
let b = order[w + 1];
let (va, vb) = (if feature == 0 { xs[a].0 } else { xs[a].1 }, if feature == 0 { xs[b].0 } else { xs[b].1 });
if va == vb {
continue; // 相同值之间切不出两个非空子集
}
let t = (va + vb) / 2.0;
let score = split_gini(xs, ys, feature, t);
let drop = parent - score;
if drop > 1e-12 && best.map_or(true, |(_, _, d)| drop > d) {
best = Some((feature, t, drop));
}
}
}
best
}
/// 递归建树(预剪枝:最大深度 + 最小分裂样本数)。
fn build_tree(xs: &[(f64, f64)], ys: &[f64], depth: usize, max_depth: usize, min_samples: usize) -> TreeNode {
if ys.iter().all(|&y| (y - ys[0]).abs() < 1e-12) {
return TreeNode::Leaf(ys[0]);
}
if depth >= max_depth || ys.len() < min_samples {
return TreeNode::Leaf(majority(ys));
}
match best_split(xs, ys) {
Some((feature, threshold, gini_drop)) => {
let mut lx = Vec::new();
let mut ly = Vec::new();
let mut rx = Vec::new();
let mut ry = Vec::new();
for (x, y) in xs.iter().zip(ys.iter()) {
let v = if feature == 0 { x.0 } else { x.1 };
if v <= threshold {
lx.push(*x);
ly.push(*y);
} else {
rx.push(*x);
ry.push(*y);
}
}
TreeNode::Branch {
feature,
threshold,
gini_drop,
left: Box::new(build_tree(&lx, &ly, depth + 1, max_depth, min_samples)),
right: Box::new(build_tree(&rx, &ry, depth + 1, max_depth, min_samples)),
}
}
None => TreeNode::Leaf(majority(ys)),
}
}
fn predict(node: &TreeNode, x: (f64, f64)) -> f64 {
match node {
TreeNode::Leaf(label) => *label,
TreeNode::Branch { feature, threshold, left, right, .. } => {
let v = if *feature == 0 { x.0 } else { x.1 };
if v <= *threshold {
predict(left, x)
} else {
predict(right, x)
}
}
}
}
/// 缩进打印整棵树——决策树"可解释性最强"的直接证据。
fn print_tree(node: &TreeNode, indent: &str) {
match node {
TreeNode::Leaf(label) => println!("{indent}→ 叶子:判为类 {label:.0}"),
TreeNode::Branch { feature, threshold, gini_drop, left, right } => {
println!(
"{indent}x{} ≤ {:.2} (Gini 下降 {:.3})",
feature + 1,
threshold,
gini_drop
);
print_tree(left, &format!("{indent} 是| "));
print_tree(right, &format!("{indent} 否| "));
}
}
}
/// 树的规模(节点数),配合深度限制观察过拟合。
fn tree_size(node: &TreeNode) -> usize {
match node {
TreeNode::Leaf(_) => 1,
TreeNode::Branch { left, right, .. } => 1 + tree_size(left) + tree_size(right),
}
}
// ===================== 数据:轴平行矩形规则 =====================
/// 类 1 = 落在矩形 [1,4]×[1,4] 内;10% 标签翻转当噪声。决策树的天然主场。
fn make_data(rng: &mut XorShift, n: usize) -> (Vec<(f64, f64)>, Vec<f64>) {
let mut xs = Vec::with_capacity(n);
let mut ys = Vec::with_capacity(n);
for _ in 0..n {
let x = (rng.next_f64() - 0.25) * 6.0; // [-1.5, 4.5]
let y = (rng.next_f64() - 0.25) * 6.0;
let mut label = if (1.0..=4.0).contains(&x) && (1.0..=4.0).contains(&y) { 1.0 } else { 0.0 };
if rng.next_f64() < 0.1 {
label = 1.0 - label;
}
xs.push((x, y));
ys.push(label);
}
(xs, ys)
}
fn accuracy(tree: &TreeNode, xs: &[(f64, f64)], ys: &[f64]) -> f64 {
let correct = xs.iter().zip(ys.iter()).filter(|(x, y)| predict(tree, **x) == **y).count();
correct as f64 / ys.len() as f64
}
fn main() {
let out_dir = "../../../frontend/public/images/series/rust-ml-12-decision-tree";
std::fs::create_dir_all(out_dir).expect("创建输出目录失败");
// ---- 1. 数据 ----
let mut rng = XorShift::new(42);
let (xtr, ytr) = make_data(&mut rng, 300);
let (xte, yte) = make_data(&mut rng, 200);
println!("train = {},test = {}(矩形规则 + 10% 标签噪声)", xtr.len(), xte.len());
// ---- 2. 深度扫描:预剪枝如何驯服过拟合 ----
println!("\n[深度扫描] max_depth 节点数 train acc test acc");
let mut tr_curve = Vec::new();
let mut te_curve = Vec::new();
let mut best_depth = (0usize, 0.0f64);
for d in [1usize, 2, 3, 4, 5, 6, 8, 12] {
let tree = build_tree(&xtr, &ytr, 0, d, 2);
let tr = accuracy(&tree, &xtr, &ytr);
let te = accuracy(&tree, &xte, &yte);
println!("{:>12} {:>6} {:>8.3} {:>8.3}", d, tree_size(&tree), tr, te);
tr_curve.push((d as f64, tr));
te_curve.push((d as f64, te));
if te > best_depth.1 {
best_depth = (d, te);
}
}
println!("test 最优:max_depth = {}", best_depth.0);
let mut c = Canvas::new(560.0, 320.0, 1.0, 12.0, 0.7, 1.02);
c.axes("max_depth", "accuracy");
c.polyline(&tr_curve, PALETTE[0], 2.0);
c.polyline(&te_curve, PALETTE[1], 2.0);
c.legend(&[("train", PALETTE[0]), ("test", PALETTE[1])]);
let p1 = format!("{out_dir}/depth-acc.svg");
c.save(&p1);
// ---- 3. 最优树的全文打印(可解释性现场) ----
// 展示用树取 depth=3:三层刚好装下矩形的四条边,规则可读
let tree = build_tree(&xtr, &ytr, 0, 3, 10);
println!("\n[max_depth = 3 学到的树(test acc = {:.3},最优 depth={} 时为 {:.3})]", accuracy(&tree, &xte, &yte), best_depth.0, best_depth.1);
print_tree(&tree, "");
// ---- 4. 决策区域图 ----
let mut region0 = Vec::new();
let mut region1 = Vec::new();
for i in 0..46 {
for j in 0..46 {
let q = (i as f64 * 0.13 - 1.6, j as f64 * 0.13 - 1.6);
if predict(&tree, q) > 0.5 {
region1.push(q);
} else {
region0.push(q);
}
}
}
let mut c = Canvas::new(560.0, 460.0, -1.6, 4.4, -1.6, 4.4);
c.axes("x1", "x2");
c.dots(®ion0, PALETTE[1], 2.2);
c.dots(®ion1, PALETTE[3], 2.2);
let class0: Vec<(f64, f64)> = xtr.iter().zip(ytr.iter()).filter(|(_, y)| **y < 0.5).map(|(x, _)| *x).collect();
let class1: Vec<(f64, f64)> = xtr.iter().zip(ytr.iter()).filter(|(_, y)| **y > 0.5).map(|(x, _)| *x).collect();
c.dots(&class0, "#16161d", 2.4);
c.dots(&class1, "#fbfaf7", 2.4);
c.legend(&[("region 0", PALETTE[1]), ("region 1", PALETTE[3])]);
let p2 = format!("{out_dir}/tree-region.svg");
c.save(&p2);
println!("图已写入:{p1}、{p2}");
}
// ===================== 迷你 SVG 绘图器(与系列前篇一致) =====================实现要点:
TreeNode用 enum 表达树:Leaf(f64)或Branch{...},Rust 的枚举允许两个变体带完全不同的字段——叶子和分支不需要统一接口。Box<TreeNode>把子树放到堆上并持有它,递归类型在 Rust 里必须经 Box 间接一层(语法角细讲)。best_split是唯一的”搜索”:两层循环(特征 × 阈值),drop > 1e-12的门槛拒绝无意义的切分。build_tree三个退出点:全同类、深度到顶、样本太少——前两个是纯度目标,第三个是预剪枝。print_tree递归缩进打印:决策树的可解释性不需要额外工具,一个递归函数就够。
// src/main.rs 段二:迷你 SVG 绘图器(与系列前篇同一份实现)
use std::fmt::Write as _;

/// 系列默认配色:朱橙 / 青绿 / 蓝 / 琥珀(取自站点设计令牌)。
const PALETTE: [&str; 4] = ["#d6491f", "#0f766e", "#2563eb", "#d97706"];

/// 一张图:坐标映射 + 已累积的 SVG 元素。
struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    /// 按数据范围自动留 5% 边距建图;xmin == xmax 时手动摊开避免除零。
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    /// 折线,点需按 x 升序传入。
    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    /// 散点。
    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    /// 坐标轴 + 虚线网格 + 刻度标签。
    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    /// 置信带:upper/lower 两条曲线围成的区域,半透明填充。
    #[allow(dead_code)] // 部分篇章不使用,保持各篇绘图器逐字一致
    fn band(&mut self, upper: &[(f64, f64)], lower: &[(f64, f64)], color: &str) {
        let mut d = String::new();
        for (i, (x, y)) in upper.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        for (x, y) in lower.iter().rev() {
            let _ = write!(d, "L{:.1},{:.1}", self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}Z" fill="{color}" fill-opacity="0.15" stroke="none"/>"##
        );
    }

    /// 图例:右上角依次画「色线 + 文字」。
    fn legend(&mut self, entries: &[(&str, &str)]) {        let sample_w = 22.0;
        let line_h = 18.0;
        let x_text = self.w - self.pad_r - 78.0 + sample_w + 6.0;
        for (i, (label, color)) in entries.iter().enumerate() {
            let y = self.pad_t + 14.0 + i as f64 * line_h;
            let x0 = self.w - self.pad_r - 78.0;
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{:.1}" y2="{y:.1}" stroke="{color}" stroke-width="2.5"/>"##,
                x0 + sample_w
            );
            let _ = write!(
                self.body,
                r##"<text x="{x_text:.1}" y="{:.1}" fill="#16161d" fill-opacity="0.7">{label}</text>"##,
                y + 4.0
            );
        }
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

/// 把 fmt 出来的 f64 末尾零去掉,让刻度标签短一点。
fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

/// 数据范围退化成一点时向两侧摊开。
fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

/// “好看”的刻度:步长取 1/2/2.5/5 × 10^k。
fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}
// src/main.rs 末尾:单元测试(cargo test 运行)
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn gini_pure_and_mixed() {
assert!(gini(&[1.0, 1.0, 1.0]).abs() < 1e-12);
assert!((gini(&[1.0, 0.0, 1.0, 0.0]) - 0.5).abs() < 1e-12);
}
#[test]
fn best_split_finds_rectangle_edge() {
// 完美矩形:x1 ∈ [0,1] 为类 1,阈值应在 0.5 附近一刀切开
let xs: Vec<(f64, f64)> = vec![(0.2, 0.0), (0.4, 0.9), (0.8, 0.3), (1.5, 0.0), (1.8, 0.7), (2.0, 0.2)];
let ys = vec![1.0, 1.0, 1.0, 0.0, 0.0, 0.0];
let (feature, threshold, drop) = best_split(&xs, &ys).expect("纯矩形应可切分");
assert_eq!(feature, 0);
assert!(threshold > 0.8 && threshold < 1.5);
assert!(drop > 0.4);
}
#[test]
fn depth_limit_is_respected() {
let mut rng = XorShift::new(3);
let (xs, ys) = make_data(&mut rng, 100);
let tree = build_tree(&xs, &ys, 0, 2, 2);
// 深度 ≤ 2 的满二叉树至多 7 个节点
assert!(tree_size(&tree) <= 7);
}
#[test]
fn pure_node_stops_splitting() {
let xs = vec![(0.1, 0.2), (0.3, 0.4), (0.5, 0.6)];
let ys = vec![1.0, 1.0, 1.0];
let tree = build_tree(&xs, &ys, 0, 8, 2);
assert!(matches!(tree, TreeNode::Leaf(v) if v == 1.0));
}
}Rust 语法角:递归数据结构——enum + Box
树是最经典的递归类型:分支里装着更小的树。Rust 要求递归必须经 Box 间接:Branch 字段的类型是 Box<TreeNode> 而不是 TreeNode——因为编译器需要知道类型的大小,“分支里套分支”的无限结构必须通过指针(Box 是堆上指针)打破这个环。每个 Box 拥有它的子树,树被丢弃时 Rust 自动从叶子向上逐个释放,没有 GC 也没有手动 free。对照 Python:节点类用 self.left = None 占位、靠垃圾回收收尾;Rust 把”子节点存在”直接编码进类型(Leaf 根本没有 left/right 字段),拿错分支编译期就报错。这是 enum 作为代数数据类型的威力——见《Rust 程序设计语言》ch06-01(枚举)与 ch15(智能指针)。
运行结果
cargo test(4 个用例:Gini 端点值、best_split 找到矩形边、深度限制生效、纯节点停止分裂)全部通过后,cargo run:
train = 300,test = 200(矩形规则 + 10% 标签噪声)

[深度扫描]  max_depth   节点数   train acc   test acc
           1        3      0.727      0.685
           2        7      0.847      0.840
           3       13      0.887      0.835
           4       21      0.917      0.860
           5       37      0.933      0.870
           6       55      0.963      0.830
           8       73      0.987      0.825
          12       87      1.000      0.825
test 最优:max_depth = 5

[max_depth = 3 学到的树(test acc = 0.835,最优 depth=5 时为 0.870)]
x2 ≤ 1.01   (Gini 下降 0.066)
  是| x1 ≤ 2.71   (Gini 下降 0.004)
  是|   是| x1 ≤ 2.64   (Gini 下降 0.015)
  是|   是|   是| → 叶子:判为类 0
  是|   是|   否| → 叶子:判为类 1
  是|   否| → 叶子:判为类 0
  否| x1 ≤ 1.00   (Gini 下降 0.175)
  否|   是| x1 ≤ -0.22   (Gini 下降 0.021)
  否|   是|   是| → 叶子:判为类 0
  否|   是|   否| → 叶子:判为类 0
  否|   否| x2 ≤ 3.86   (Gini 下降 0.117)
  否|   否|   是| → 叶子:判为类 1
  否|   否|   否| → 叶子:判为类 0
图已写入:../../../frontend/public/images/series/rust-ml-12-decision-tree/depth-acc.svg、../../../frontend/public/images/series/rust-ml-12-decision-tree/tree-region.svg
两张图:
怎么读这些数字和图
- 深度扫描是过拟合的现场直播:train acc 从 0.727 一路爬到 1.000(depth=12 时 87 个节点的树把每个噪声点都供了起来),test acc 却在 depth=5(0.870)后掉头滑到 0.825。两条曲线的分岔点就是预剪枝的坐标——深度、最小样本数,都是在这条缝里取值。
- 树的打印就是学到的规则本身:根节点
x2 ≤ 1.01正是矩形的下边,右枝的x1 ≤ 1.00是左边、x2 ≤ 3.86≈4 是上边——三条边被三刀重现。第四条边(x1≤4)藏在 depth=4 之后。这就是清单说的”画出来给人看”的解释力。 - 但注意 Gini 下降 0.004 的那几刀:
x1 ≤ 2.71切出的子节点几乎不纯度的改善——那是 10% 翻转噪声在规则里留下的毛刺。决策树的”不稳定”(清单缺点:换一个样本树形可能大变)就藏在这些小数里,也是随机森林(集成学习篇)要治的病。 - 决策区域图是”轴平行”的直观展示:矩形色块边界全部平行于坐标轴——决策树表达不了斜线。数据若是斜向分布,树只能用阶梯线逼近斜边(大量浅切分),这正是它对比逻辑回归的结构性短板。
优缺点与适用场景
(抄清单 2.4 原文)
- 优点:可解释性最强(画出来给人看)、无需标准化、天然处理类别特征和缺失值。
- 缺点:极易过拟合(必须剪枝)、对数据扰动敏感(换一个样本树形可能大变)、决策边界只能是轴平行的。
- 适用场景:需要向业务方解释规则的场景、作为集成学习的基学习器。
小结
决策树用”纯度尺子 + 贪心切分”把分类问题变成了递归的搜索问题,规则可读是它无可替代的长项,贪心与轴平行是它的结构性天花板。好消息:它的病都有药——深度限制今天已经用了,不稳定性则要请出”三个臭皮匠”:集成学习篇的随机森林会用几百棵这样的树投票,把方差熨平。下一篇分类⑤:支持向量机——间隔最大化与核技巧,分类模块的理论高峰。