用 Rust 从头实现机器学习算法·降维:主成分分析——沿着方差最大的方向观察数据
用 Rust 从头实现机器学习算法·降维:主成分分析——沿着方差最大的方向观察数据
降维要回答的第一个问题:数据真的需要观察那么多维度吗?如果 和 强相关,一个变量就几乎决定了另一个——第二个维度大半是冗余。主成分分析(PCA) 为数据找一组新的正交坐标轴:第一根轴落在方差最大的方向上,后面的轴按方差大小依次排列,重点关注前几个主成分,就能在低维空间里观察数据的主要结构。PCA 是无监督的:关心方差最大化,计算过程不依赖样本标签。
本文使用经典数据集:鸢尾花数据集(150 个样本 × 4 个特征:花萼长/宽、花瓣长/宽,厘米)作为输入,4 维压到 2 维画图。两条路线实现 PCA: 路线一 手写雅可比旋转(Jacobi rotation)把 协方差矩阵迭代成对角阵,特征向量就是主成分方向; 路线二 手写单边雅可比 SVD 直接分解数据矩阵,使用奇异值分解的方式得到主成分。 两条路线的结果完全一致,最后对照 sklearn 的实现,说明差异与数值行为。
核心思想
清单的定义一句话:找到数据方差最大的方向,依次取互相正交的主成分,投影即完成降维。直觉很直白:方差大的方向信息量大(数据在这个方向上”摊开”),方差小的方向多半是噪声(数据挤成一条线)。PCA 只关心方差、不需要标签——这是无监督的标志性特征。
两个重要性质:主成分之间正交,输出特征天然不相关,多重共线性随之消除;保留多少信息用累计方差贡献率衡量——鸢尾花例子里前两个主成分累计占 97.8%,丢掉后两维几乎无损。
数学推导
从数据到协方差矩阵
步骤三步走:中心化(每列减均值)→ 算协方差矩阵 → 分解。特征向量是主成分方向,特征值是该方向上的方差。取前 个特征向量作投影矩阵 , 的数据就变成 。
注意 最大——花瓣长与花瓣宽的相关性最强,这正是 PCA 要利用的冗余。分母用 而非 : 时两者差不到 1%,本文全程用 约定(sklearn 用 ,见后文对照)。
标准化提醒:降维前必须标准化特征,否则量纲大的特征会 dominate。鸢尾花四个特征同单位(厘米),量纲一致,本文用原始尺度;特征量纲混杂时需先做 。
路线一:雅可比旋转特征分解(协方差矩阵 EVD)
适用场景: 是 实对称矩阵, 很小,教科书标准路线,几何视角清晰(椭球的长短轴)。
第 1 块:被加工的完整矩阵
就是鸢尾花的协方差矩阵 (,见上)。扫描全部 6 个非对角元(),绝对值最大的是 (花瓣长 × 花瓣宽的协方差)。本轮目标:通过旋转让第 (3,4) 位置变成 0。
第 2 块:旋转矩阵 (完整写出)
只动第 3、4 行/列,其余保持单位阵:
它的转置(行和列互换):
第 3 块:完整计算 (分两步乘)
第一步:。 矩阵乘法定义: 的第 行第 列 = 的第 行点乘 的第 列。 的第 1、2 列就是单位向量,所以 的第 1、2 列原样照抄 ;只有第 3、4 列会变:
- 的第 3 列 = →
- 的第 4 列 = →
第二步:。 的第 1、2 行是单位向量 → 的第 1、2 行照抄 ;只有第 3、4 行变:
第 4 块:盯住目标元素 ,解出
= 的第 3 行点乘 的第 4 列。 第 3 行只有第 3、4 列非零(),代入第 3 块的 、:
令 ,用二倍角公式 、:
代入数字:
分母为负 → 落在第二象限:,即
这就是代码用 atan2(分子, 分母) 而不是 atan(分子/分母) 的原因——它自动处理符号、自动选对分支,且 时分母为零也不溢出。符号警示:分母必须是 (),写反的话旋转不会消元,反而把 转到极大值——矩阵看似在迭代,实则永不收敛。
第 5 块:旋转后的完整矩阵 (真实数值结果)
把 代回第 3 块的所有式子:
逐格检查这一轮发生了什么:
- 目标达成:(程序里直接置 0,防浮点残差)✓
- 付出的代价: 全部变了——消灭一个、惊动四个。这就是必须迭代的原因:下一轮扫描新的最大元(现在是 ),继续消。
- 守恒校验:对角线之和旋转前 ,旋转后 ——迹不变,特征值没有丢失 ✓
- 对角线的去向:方差在往”大角”集中( 变大、 变小)。继续迭代下去,非对角元全部趋于 0,对角线收敛到四个特征值。
迭代、收敛与特征向量的累积
每一轮:扫描严格上三角找最大 → 按上面的公式旋转 → 同步把 累积进 ( 初值为单位阵)。收敛判据:最大非对角元 。本例实际迭代 16 轮。收敛后 的对角元即特征值,按降序重排(同步重排 的列):
贡献率: 独占 ,前两个累计 ——保留前两个主成分。
数学 ↔ 代码对应表
| 数学(本推导,1-based) | 代码(0-based) |
|---|---|
| 非对角元 | ip = 2, iq = 3 |
app = a[[2,2]], aqq = a[[3,3]], apq = a[[2,3]] | |
theta = 0.5 * (2.0*apq).atan2(aqq - app) | |
| (改第 p/q 列) | 第一个 for k in 0..p 循环 |
| (改第 p/q 行 + 2×2 主块) | 对角元更新 + 对称补半 |
| 累积 | 第二个 for k in 0..p 循环 |
| 收敛判据 max|A_pq| < tol | if max_val < tol { break } |
路线二:单边雅可比 SVD(直接分解数据矩阵)
适用场景:需要避免显式构造协方差矩阵时(如数据接近病态),直接分解中心化数据矩阵 ()——数值稳定性更好,是实践中的标准路线。
第 1 块:目标变了——不再磨矩阵,而是”把列旋成正交”
的 4 列是 4 个中心化特征。PCA 要的主成分 是 的特征向量;而列两两正交正是” 是对角阵”的几何说法。所以路线二的迭代目标是:不断右乘平面旋转矩阵 ,把 的两列旋到正交,直到所有列两两正交。
先看 Gram 矩阵 ()。真实运行的第一轮:
注意 ——每个元素恰好是协方差矩阵的 150 倍( ✓)。最大非对角元同样是第 (3,4) 个:(列间内积)。
第 2 块:一次列旋转(完整推导)
与路线一第 2 块的形式完全相同。 只改第 两列:
正交条件 。记 、、(恰好是 的 主子块 的三个元素),逐项展开:
令其为 0,得 ——与路线一的公式逐字同型( 对应 ),只是把相似变换换成了对数据列的直接旋转。分母同样是 不能写反,同一个坑。
代入数字:
与路线一第一轮完全相同的 和 ——因为 的主子块就是 的主子块,atan2 的两个参数同乘 150,比值不变。这不是巧合:两条路线在数学上是同一件事的两侧(下一块证明)。
第 3 块:为什么”转列”等价于”相似变换”(Gram 视角)
对 右乘 时,Gram 矩阵同步变化:
左边是”旋转后数据”的 Gram 矩阵,右边是”对 做雅可比相似变换”——转数据列 = 转 Gram 阵,一步到位。区别在于路线一先显式算出 再分解 矩阵;路线二永远不构造 ,只对 本身()做旋转。每轮的成本从”改 矩阵的两行两列”变成”改 150 行 × 2 列”,代价同阶,但精度账完全不同(第 5 块)。
第 4 块:收敛后读出 SVD
收敛判据:最大 (实际同样 16 轮)。此时 的列两两正交( 是逐轮累积的旋转矩阵之积,天然正交)。把正交列单位化、记下列长:
真实读出的奇异值(降序重排后)与换算:
| 与路线一的 | |||
|---|---|---|---|
| 1 | 25.089864 | 4.196675 | 4.196675 ✓ |
| 2 | 6.007853 | 0.240629 | 0.240629 ✓ |
| 3 | 3.420535 | 0.078000 | 0.078000 ✓ |
| 4 | 1.878502 | 0.023525 | 0.023525 ✓ |
的来源:(用 消掉中间的 ),对照谱分解 得 、。
第 5 块:为什么路线二数值更稳——条件数平方
条件数 衡量矩阵”接近不可逆”的程度,浮点误差大约按 放大。构造 把每个元素平方了一遍,条件数跟着平方:
鸢尾花 约几十,平方后上千——小奇异值对应的成分在 里被淹没的精度,比直接对 旋转深了一个数量级。单边雅可比始终只碰 本身,精度损失与 同阶,因此被视为最精确的 SVD 算法(Golub & Van Loan §8.6)。代价:每轮要算 列的内积;本例 ,代价可忽略; 到百万级时工业实现会改用更快的双对角化算法(见后文 sklearn 一节)。
数学 ↔ 代码对应表
| 数学(1-based) | 代码(0-based) |
|---|---|
| 等 | b.column(p).dot(&b.column(p)) 等 |
theta = 0.5 * (2.0*gamma).atan2(beta - alpha) | |
for r in 0..m 就地更新两列 | |
| 累积 | for r in 0..n 同步旋转 |
| 、 | 收敛后的读出循环 |
| 、 | `eigenvalues = s.mapv( |
两条路线对照
| 路线一(EVD) | 路线二(SVD) | |
|---|---|---|
| 分解对象 | 协方差矩阵 () | 数据矩阵 () |
| 每轮操作 | 改 的 p/q 两行两列() | 旋 的两列() |
| 数值稳定性 | 平方,小成分易淹没 | 与 同阶,最稳 |
| 本文实跑 | 16 轮 / 3.02 ms | 16 轮 / 5.59 ms |
| 结论 | 教科书路线、几何直观 | 实践标准、工业默认 |
两条路线给出的主成分差异只在浮点尾差量级(实跑 max|Δλ| = 7.5e-16,max|ΔZ| = 1.6e-15)—、—数值行为完全一致。路线二的优势在于不显式构造协方差矩阵,避免了 平方的精度损失。
sklearn 是如何实现 PCA 的,与本文手写实现的差异有哪些?
sklearn 的机器学习项目,实现PCA分析只需要from sklearn.decomposition import PCA; PCA(n_components=2).fit_transform(X) 一行即可,无需关心旋转矩阵。但是值得注意的是,sklearn 内部的实现与本文手写实现有一些差异:
- SVD分解优先:sklearn 的
PCA内部对中心化后的数据直接调scipy.linalg.svd——和本文路线二一样从不显式构造协方差矩阵,正是为了避开 平方。 - 但 SVD 算法不同:SciPy 底层是 LAPACK 的
gesdd——先把矩阵 Householder 变换成双对角阵,再用分治(divide-and-conquer)递归求特征值。单边雅可比与它是两种不同的 SVD 算法,各有适用面:双对角化 + 分治经过数十年工业验证,在大型矩阵上显著更快;单边雅可比的精度与 同阶、实现简单,且天然便于只计算部分分量。svd_solver='auto'时,若n_components < 0.8·min(n, p)还会改用随机化 SVD(Halko 算法,用随机投影把矩阵压窄再分解)或 ARPACK 迭代——只算前 个分量,不算全量;本文手写实现是全量分解。 - 一个真实的数值差异:sklearn 的
explained_variance_是 (无偏估计,分母 ),本文用 。鸢尾花上两者差 ——特征值整体差一个常数因子,方向、贡献率、投影坐标都不受影响,但跨实现比对数字时这个因子必须先对齐。 - 速度差距的本质:LAPACK/BLAS 是经过几十年调优的 Fortran 代码,向量化、分块、缓存友好;手写 ndarray 循环服务于教学,性能不在同一量级。4 维协方差上差距无从体现,百万维规模下是数量级。
- 分工:工程场景应使用 sklearn——其 LAPACK 实现在速度与数值稳定性上都经过长期验证,均优于手写实现。手写实现的价值在于过程可见:每一步可打印、可手算、可对照,第 1 轮的 用普通计算器即可复核。
Rust 实现
工程结构与一个例外声明
系列前篇全部 std-only 单文件,本篇是唯一的例外:Cargo.toml 引入两个 crate——polars 只负责读 CSV(手写 CSV 解析不是本篇的主题),ndarray 只提供矩阵容器与广播/视图语义。两个算法核心(雅可比特征分解、单边雅可比 SVD)依旧逐行手写,位于 mod linalg:
[dependencies]
# 本篇是系列中唯一引入外部 crate 的篇章:
# polars 只负责读 CSV,ndarray 只提供矩阵容器与视图语义;
# 特征分解与 SVD 两个算法核心仍是逐行手写(mod linalg)。
ndarray = "0.17"
polars = "0.46"
段一:数据加载(polars → ndarray)
// src/main.rs 段一:模块一 io —— 读 CSV,只保留数值列(自动跳过 species),返回 n×p
mod io {
    use super::*;

    /// 读 CSV,只保留数值列(自动跳过 species 这类字符串列),
    /// 返回 n 行 p 列的 Array2<f64>。
    ///
    /// 整体数据格式的流转(鸢尾花为例:n=150 行样本,p=4 个数值特征):
    ///   CSV 文件 → polars DataFrame(4 个数值列 + 1 个字符串列 species)
    ///            → 每个数值列 Series 按值消耗成 Vec<f64>(长度 n=150)
    ///            → 每个 Vec<f64> 转成 Array1<f64>(p 个列向量)
    ///            → 借用成 ArrayView1(零拷贝视图,仅为拼接服务)
    ///            → stack 沿 Axis(0) 纵向拼接成 p×n(4×150)
    ///            → .t() 零拷贝转置成视图 n×p(150×4)
    ///            → .to_owned() 物化成拥有所有权的 n×p Array2
    pub struct CsvPath<'a> {
        pub path: &'a str,
        pub has_header: bool,
    }

    pub fn load_csv_numeric(csv_path: CsvPath) -> Result<Array2<f64>, Box<dyn Error>> {
        let df = CsvReadOptions::default()
            .with_has_header(csv_path.has_header)
            // path: &str 先 into() 成 PathBuf,再 Some 包成 Option<PathBuf>
            // try_into_reader... 和 finish() 都返回 Result,? 表示失败时
            // 立即把整个函数的 Err 返回(错误向上传播,main 里再统一处理)
            .try_into_reader_with_file_path(Some(csv_path.path.into()))?
            .finish()?; // 完成后 df: DataFrame,拥有全部列数据
        println!("CSV {}", csv_path.path);
        let mut cols: Vec<Array1<f64>> = Vec::new();
        for col in df.get_columns() {
            // col.f64() 尝试把这一列解释成 f64:
            //   数值列 → Ok(Series);species 这类字符串列 → Err,被 if let 直接跳过
            // 这就是"自动剔除非数值列"的实现点
            if let Ok(s) = col.f64() {
                // 所有权:s.into_iter() 按值消耗 Series(所有权 move 进迭代器),
                //   逐项吐出 Option<f64>(单元格缺失时为 None)
                // 格式:Series(polars 列)→ Vec<f64>(n 个元素的连续缓冲)
                let v: Vec<f64> = s.into_iter().map(|x| x.unwrap_or(f64::NAN)).collect();
                // 所有权:Vec 的堆缓冲被 move 进 ndarray,不复制数据
                // 格式:Vec<f64> → Array1<f64>,一个长度为 n 的 1 维列向量
                cols.push(Array1::from_vec(v));
            }
        }
        if cols.is_empty() {
            return Err("CSV 中没有数值列".into());
        }
        // 所有权/格式:cols.iter() 借用每个 Array1(&Array1),.view() 再借出
        // ArrayView1 —— 不拷贝数据,只是一个(指针+长度+步长)的只读视图。
        // 视图必须有自己的生命周期载体(views 这个 Vec),因为 stack 只借用它们。
        let views: Vec<ArrayView1<f64>> = cols.iter().map(|c| c.view()).collect();
        // 格式:p 个长度为 n 的向量沿 Axis(0) 纵向拼 → p×n 矩阵(4×150)
        //       .t() 是零拷贝转置,只交换视图形状/步长 → n×p 视图(150×4)
        // 所有权:.to_owned() 把转置视图真正拷贝成一块连续内存的拥有矩阵,
        //         stack 的临时结果(p×n)在这里被丢弃,最终只保留 n×p
        let x = stack(Axis(0), &views)?.t().to_owned();
        // 数据清洗:文件末尾的空行会被 polars 读成"整行 null",上一步已变成 NaN,
        // 不剔除的话 NaN 会顺着中心化传播进协方差,特征值全是 NaN。
        // 数学:等价于删除含缺失值的样本行;
        // 格式:先筛出"所有元素都有限"的行号表 keep,再按行 gather,
        //       形状 n×p → n'×p(鸢尾花去掉尾部空行后 n'=150)
        let keep: Vec<usize> = (0..x.nrows())
            .filter(|&i| x.row(i).iter().all(|v| v.is_finite()))
            .collect();
        Ok(x.select(Axis(0), &keep))
    }

    /// 读 CSV 中某一列的字符串标签(如 species),返回长度 n 的 Vec<String>。
    /// 供散点图按类别分色使用;行数与 load_csv_numeric 的 NaN 清洗结果保持一致
    /// (文件末尾空行在该列为 null,这里随 null 一并剔除)。
    pub fn load_csv_labels(
        csv_path: CsvPath,
        column: &str,
    ) -> Result<Vec<String>, Box<dyn Error>> {
        let df = CsvReadOptions::default()
            .with_has_header(csv_path.has_header)
            .try_into_reader_with_file_path(Some(csv_path.path.into()))?
            .finish()?;
        let s = df.column(column)?;
        let labels: Vec<String> = s
            .str()?
            .into_iter()
            .flatten()
            .map(str::to_string)
            .collect();
        Ok(labels)
    }
}
实现要点:
col.f64()返回Err的列(species)被if let静默跳过——“自动剔除非数值列”就是这一个匹配。- NaN 清洗是踩过的坑:CSV 尾部空行 → 整行 null → 中心化后协方差全是 NaN。
keep行号表 + 按行select两步删掉。 stack → .t() → .to_owned()的三连是 ndarray 所有权语义的缩影:拼出来的是 ,转置是零拷贝视图,最后物化成 的拥有矩阵(语法角详谈)。- 标签单独读一份,供散点图分色;只取非 null 行,与数值清洗天然对齐(空行的 species 也是 null)。
段二:雅可比特征分解(路线一)
// src/main.rs 段二:mod linalg 之 1 —— 实对称矩阵特征分解:雅可比旋转法
mod linalg {
    use super::*;

    /// ------------------------------------------------------------------
    /// 1. 实对称矩阵特征分解:雅可比旋转法(对应文章路线一推导)
    ///    输入 A (p×p, 对称),返回 (λ, V, history):
    ///      - λ:特征值,降序
    ///      - V:p×p,第 j "列"是 λ_j 对应的单位特征向量
    ///      - history:每轮最大非对角元 |A_pq|,收敛曲线图的数据
    ///    原理:反复做平面旋转 A ← JᵀAJ 消去最大非对角元,
    ///          A 收敛到 diag(λ),旋转矩阵累积积即为 V。
    /// ------------------------------------------------------------------
    pub fn jacobi_eigen_symmetric(
        a: &Array2<f64>, // 只借用入参,本函数不夺走调用者的矩阵
        max_sweeps: usize,
        tol: f64,
    ) -> (Array1<f64>, Array2<f64>, Vec<f64>) {
        // 格式:p = 方阵阶数(鸢尾花协方差矩阵为 4)
        let p = a.nrows();
        println!("特征分解矩阵阶数 p = {}", p);
        // 所有权:a 是 &Array2(借来的),算法要原地修改矩阵,
        //         所以 .to_owned() 深拷贝一份"工作副本",调用者的原矩阵不受影响
        let mut a = a.to_owned();

        // 数学:V 的初值是单位阵 I;每轮把旋转矩阵 J 右乘累积进去(V ← V·J),
        //       循环结束后 V 的各列就是全部特征向量
        // 格式:p×p 方阵,所有权为本函数私有
        let mut v = Array2::<f64>::eye(p);
        // 调试输出:V 初值应为 4×4 单位阵(对角 1、其余 0)
        println!("累积旋转矩阵 V(初值=I) = \n{:?}", &v);

        // 收敛历史:每轮的最大非对角元,画收敛曲线用
        let mut history: Vec<f64> = Vec::new();

        // 数学:一轮 sweep = 把当前最大非对角元消成 0(一次旋转会把它"清零",
        //       但会搅乱之前消过的元素,所以要反复扫描直到全部 < tol)
        for sweep in 0..max_sweeps {
            // (a) 扫描严格上三角,找绝对值最大的非对角元 a[ip][iq]
            //     数学:特征值误差 ≈ 最大非对角元的量级,消它就是消误差
            println!("\n========== [路线一·协方差特征分解] 迭代轮次 {} ==========", sweep + 1);
            println!("工作矩阵 A =\n{:?}", &a);
            let (mut max_val, mut ip, mut iq) = (0.0f64, 0usize, 1usize);
            for i in 0..p {
                for j in (i + 1)..p { // j 从 i+1 开始:对角元跳过、对称元只看一半
                    if a[[i, j]].abs() > max_val {
                        max_val = a[[i, j]].abs();
                        ip = i;
                        iq = j;
                    }
                }
            }
            history.push(max_val);
            // 调试输出:最大非对角元随轮次下降 → 0 的过程即收敛过程
            println!("最大非对角元 |a[{}][{}]| = {:.6e}", ip, iq, max_val);
            // 数学:所有非对角元都已 ≈ 0 → A 已是对角阵,收敛退出
            if max_val < tol {
                println!("已收敛(max_val < tol = {:.0e}),共迭代 {} 轮", tol, sweep + 1);
                break;
            }
            // 缓存旋转涉及的三个元素(旋转公式要同时用到旧值)
            let app = a[[ip, ip]];
            let aqq = a[[iq, iq]];
            let apq = a[[ip, iq]];
            // 调试输出:本轮要消的元,及其所在的 2×2 主子块对角
            println!(
                "消元对象 a[{}][{}] = {:.6e},主子块对角 a[{}][{}] = {:.6}, a[{}][{}] = {:.6}",
                ip, iq, apq, ip, ip, app, iq, iq, aqq
            );
            // (b) 旋转角 θ:要求旋转后 a'[ip][iq] = 0,展开 JᵀAJ 的该元素得
            //       (c²−s²)·a_pq + s·c·(a_pp − a_qq) = 0
            //     ⟹ tan(2θ) = 2·a_pq / (a_qq − a_pp)   ← 注意分母是 a_qq − a_pp!
            //       若把分母写反,旋转不会消元反而把 |a_pq| 转到极大值,
            //       矩阵看似在迭代,实则永不收敛
            // 数学:用 atan2(y, x) 而不是 atan(y/x),可同时确定象限,
            //       且 a_pp = a_qq 时分母为 0 也不会溢出
            let theta = 0.5 * (2.0 * apq).atan2(aqq - app);
            let c = theta.cos();
            let s = theta.sin();
            // 调试输出:合并到一行,方便与路线二的格式对齐比较
            println!(
                "旋转角 θ = {:.6},J = [[c, s], [-s, c]] = [[{:.6}, {:.6}], [{:.6}, {:.6}]]",
                theta, c, s, -s, c
            );
            // (c) A ← JᵀAJ:J 只作用在 (ip, iq) 平面上,所以只有 ip、iq
            //     两行两列会变,其余元素不动 —— 这就是雅可比法 O(p) 每轮的原因
            for k in 0..p {
                if k != ip && k != iq {
                    // 先读出旧值(新 a[k,ip] 依赖旧 a[k,iq],顺序不能颠倒)
                    let akp = a[[k, ip]];
                    let akq = a[[k, iq]];
                    // 数学:行/列混合变换对第 k 行的作用:
                    //   a'[k,ip] = c·a[k,ip] − s·a[k,iq]
                    //   a'[k,iq] = s·a[k,ip] + c·a[k,iq]
                    a[[k, ip]] = c * akp - s * akq;
                    a[[ip, k]] = a[[k, ip]]; // 利用对称性补另一半,省一半计算
                    a[[k, iq]] = s * akp + c * akq;
                    a[[iq, k]] = a[[k, iq]];
                }
            }
            // 数学:2×2 主对角块的变换结果(把 a_pq 消成 0 后剩下的部分):
            //   a'[ip][ip] = c²·a_pp − 2sc·a_pq + s²·a_qq
            //   a'[iq][iq] = s²·a_pp + 2sc·a_pq + c²·a_qq
            a[[ip, ip]] = c * c * app - 2.0 * s * c * apq + s * s * aqq;
            a[[iq, iq]] = s * s * app + 2.0 * s * c * apq + c * c * aqq;
            // 数学:被消去的那个非对角元,直接置 0(理论上已是 0,防浮点残差)
            a[[ip, iq]] = 0.0;
            a[[iq, ip]] = 0.0;
            // (d) 累积特征向量 V ← V·J:V 的第 ip、iq 两列做同样的平面旋转
            //     数学:A 在左乘 Jᵀ 右乘 J 下特征值不变,特征向量则按 V ← V·J 累积
            for k in 0..p {
                let vkp = v[[k, ip]];
                let vkq = v[[k, iq]];
                v[[k, ip]] = c * vkp - s * vkq;
                v[[k, iq]] = s * vkp + c * vkq;
            }
            // 调试输出:旋转后的工作矩阵 —— a[ip][iq] 应已被零化,
            //   对角线逐步逼近最终特征值,可逐轮与路线二的输出对照
            println!("旋转后 A =\n{:?}", &a);
            println!("累积特征向量矩阵 V =\n{:?}", &v);
        }
        // (e) 收敛后 A 的对角元就是特征值;逐对角线元素收集成向量
        // 格式:Array2 的对角线 → Array1(长度 p)
        let vals = Array1::from_iter((0..p).map(|j| a[[j, j]]));
        println!("特征值向量 = \n{:?}", &vals);
        let (sv, sev) = sort_desc(&vals, &v);
        (sv, sev, history)
    }
实现要点:
- 数学↔代码逐行对应上文第 1~5 块:扫描(a)、解 (b)、(c)、累积 (d)、读出(e)。
- 工作副本
a.to_owned():入参是借用,旋转要原地改,拷贝一份保护调用者的 (后面一致性检查还要用原矩阵)。 history顺手收集每轮最大非对角元,给收敛曲线图供数。- 两个工程细节:
k != ip && k != iq跳过了不该动的行列;被消元显式置 0 防浮点残差。
段三:单边雅可比 SVD(路线二)
    /// ------------------------------------------------------------------
    /// 2. 单边雅可比 SVD:A = U·S·Vᵀ(对应文章路线二推导)
    ///
    /// 【定义】A (m×n) 的奇异值分解:A = U·Σ·Vᵀ
    ///   - V (n×n) 是正交矩阵,列 v_j 称"右奇异向量"
    ///   - Σ (n×n) 是对角阵,对角元 σ_1 ≥ σ_2 ≥ … ≥ σ_n ≥ 0 称"奇异值"
    ///   - U (m×n) 列两两正交(u_i·u_j = δ_ij),称"左奇异向量"
    ///   与特征值的关系:σ_j = √λ_j(AᵀA),v_j 是 AᵀA 的单位特征向量。
    ///
    /// 【核心等价关系 —— 为什么可以"只转列"】
    ///   对 A 的列做正交变换 A ← A·J(J 是 (p,q) 平面的旋转矩阵)时,
    ///   Gram 矩阵 G = AᵀA 同步做正交相似变换:
    ///       (A·J)ᵀ(A·J) = Jᵀ(AᵀA)J = JᵀGJ
    ///   即"旋转 A 的列" 与 "对 G 做雅可比相似变换" 是同一件事的两侧:
    ///     - 路线一先显式构造 G 再分解:G 的元素是 A 元素的平方,
    ///       条件数 κ(G) = κ(A)²,小奇异值分量平方后淹没于舍入误差;
    ///     - 单边雅可比始终只对 A 本身操作,精度只受 κ(A) 影响,
    ///       因此被视为最精确的 SVD 算法(Golub & Van Loan §8.6)。
    ///
    /// 【算法流程】
    ///   1) 每轮找 Gram 矩阵的最大非对角元 |g_pq| = |col_p·col_q|
    ///   2) 选旋转角 θ 把 g_pq 零化(旋转后两列正交)
    ///   3) 执行 B ← B·J,并同步累积 V ← V·J
    ///   4) 收敛后 B 的列两两正交:设 σ_j = ‖col_j(B)‖,则 B = Û·Σ̂,
    ///      于是 A = B·Vᵀ = Û·Σ̂·Vᵀ 正是 A 的 SVD
    ///   经典 Jacobi 最大元主元策略收敛(渐近二次收敛,
    ///   Forsythe & Henrici 1960),max_sweeps 只是保险上限。
    ///
    /// 适用条件:m >= n(行数 >= 列数;不满足可先转置再调整)。
    /// 返回 (U: m×n, S: n 维, Vᵀ: n×n, history),奇异值降序。
    /// ------------------------------------------------------------------
    pub fn svd_one_sided_jacobi(
        a: &Array2<f64>, // 借用入参;这里是中心化数据 X̃(150×4)
        max_sweeps: usize,
        tol: f64,
    ) -> (Array2<f64>, Array1<f64>, Array2<f64>, Vec<f64>) {
        // 格式:(m, n) = (150, 4);m = 样本数(行),n = 特征数(列)
        let (m, n) = a.dim();
        // 数学:单边雅可比只在列空间(n 维)里做旋转,要求 m ≥ n(样本数 ≥ 特征数),
        //       保证 n 个列方向放得下 n 个正交向量;否则列不满秩,奇异值分解不唯一
        assert!(m >= n, "单边雅可比 SVD 要求行数 >= 列数");
        // 所有权:入参 a 是 &Array2(借用,不能原地改),to_owned() 深拷贝出工作副本 b
        // 数学:迭代中 b 的列被逐步旋成两两正交;等价地,
        //       Gram 矩阵 G = BᵀB 被逐步相似变换成对角阵 diag(σ_1², …, σ_n²)
        let mut b = a.to_owned();
        // 数学:累积旋转矩阵 V,初值为单位阵 I(零次旋转 = 恒等变换)。
        //   第 t 轮旋转 J_t 后 B_t = B_{t-1}·J_t,递推展开 T 轮得
        //     B_final = A·(J_1·J_2·…·J_T) = A·V
        //   括号里的乘积正是逐轮右乘累积出来的 V。收敛后 V 的列 v_j 是
        //   AᵀA 的单位特征向量(右奇异向量);且 V 作为正交阵之积天然正交(VᵀV = I),
        //   这保证了读出的 v_j 单位长、两两正交。
        // 格式:n×n 方阵
        let mut v = Array2::<f64>::eye(n);
        // 调试输出:V 初值应为 4×4 单位阵(对角 1、其余 0)
        println!("累积旋转矩阵 V(初值=I) = \n{:?}", &v);

        // 收敛历史:每轮最大 |Gram 非对角元|,画收敛曲线用
        let mut history: Vec<f64> = Vec::new();

        // 数学:sweep = 扫掠轮次编号,每轮只做一次旋转(零化当前最大非对角元)。
        //   经典 Jacobi 最大元主元策略收敛,且渐近二次收敛,
        //   本问题(4 列)通常十轮以内即到 1e-10 以下,200 是保险上限
        for sweep in 0..max_sweeps {
            // (a) 计算完整的 Gram 矩阵 G = BᵀB(n×n,n=4 很小),
            //     同时从中找最大非对角元 |g_pq| 作为本轮主元。
            //   数学:g_ij = col_i·col_j;G 对称,理论上只需算一半,
            //   但 n=4 时全算 16 个内积更省事,且调试可以直接展示整个 G。
            //   格式:b.column(i) 是零拷贝列视图(ArrayView1),不产生副本
            let mut gram = Array2::<f64>::zeros((n, n));
            for i in 0..n {
                for j in 0..n {
                    gram[[i, j]] = b.column(i).dot(&b.column(j));
                }
            }
            let (mut max_g, mut p, mut q) = (0.0f64, 0usize, 1usize);
            for i in 0..n {
                for j in (i + 1)..n {
                    if gram[[i, j]].abs() > max_g {
                        max_g = gram[[i, j]].abs();
                        p = i;
                        q = j;
                    }
                }
            }
            history.push(max_g);
            // 调试输出(与路线一格式对齐,方便逐轮对比):
            //   用 Gram 矩阵代替整个 B(150×4)打印——非对角元即列间内积,
            //   趋近 0 的过程一目了然;对角元是 σ_j² 的当前估计。
            println!("\n========== [路线二·单边雅可比 SVD] 迭代轮次 {} ==========", sweep + 1);
            println!("Gram 矩阵 BᵀB =\n{:?}", &gram);
            // 调试输出:可观察 max_g 随轮次下降 → 0 的全过程(收敛可视化)
            println!("最大列间内积 |col_{} · col_{}| = {:.6e}", p, q, max_g);
            // 数学:收敛判据。所有非对角元 < tol 时,G 已(数值上)对角化,
            //   B 的列两两正交,可以跳出循环读出 SVD。
            //   tol 取绝对值 1e-10:本问题 γ 的量级 ~σ² ~ 400,相对精度 ~1e-13
            if max_g < tol {
                println!("已收敛(max_g < tol = {:.0e}),共迭代 {} 轮", tol, sweep + 1);
                break;
            }
            // (b) 计算旋转角 θ,使旋转后第 p、q 列正交(即把 γ 零化)。
            //   【逐步推导】记 α = p·p = ‖col_p‖²,β = q·q = ‖col_q‖²,γ = p·q,
            //   旋转后的新列为 p' = c·p − s·q,q' = s·p + c·q,正交条件 p'·q' = 0:
            //     p'·q' = (c·p − s·q)·(s·p + c·q)
            //           = cs(p·p) + c²(p·q) − s²(q·p) − sc(q·q)
            //           = cs(α − β) + (c² − s²)γ
            //           = ½·sin2θ·(α − β) + cos2θ·γ          (二倍角公式)
            //   令其为 0,得 tan(2θ) = 2γ / (β − α)。
            //   【与路线一对照】这正是 2×2 对称阵 [[α,γ],[γ,β]] 的雅可比旋转角,
            //     只是直接作用在数据列上,而非先平方构造 Gram 阵再分解。
            //   【符号警示】分母是 β − α(q 列范数² 减 p 列范数²),
            //     写反会得到把 |γ| 转到极大的角 —— 与特征分解路线同型的坑
            // 数学:α、β、γ 恰好组成 Gram 矩阵 G = BᵀB 的 2×2 主子块 [[α,γ],[γ,β]]
            let alpha = b.column(p).dot(&b.column(p));
            let beta = b.column(q).dot(&b.column(q));
            let gamma = b.column(p).dot(&b.column(q));
            // 数学:θ = ½·atan2(2γ, β−α)。atan2 相比 atan 的三个优势:
            //   1) 同时确定象限,θ 直接落在正确分支,无需 ±π/2 修正;
            //   2) β = α(两列等长)时分母为 0,atan2(y, 0) = ±π/2,不除零溢出;
            //   3) γ = 0(已正交)时 θ = 0,自动退化为"不旋转"
            let theta = 0.5 * (2.0 * gamma).atan2(beta - alpha);
            let c = theta.cos();
            let s = theta.sin();
            // 调试输出:α/β/γ 即 Gram 矩阵 2×2 主子块的三个量,
            //   γ 应与上面打印的 gram[p][q] 一致;θ、J 供手工验证正交条件 p'·q' = 0
            println!(
                "α = ‖col_{}‖² = {:.6}, β = ‖col_{}‖² = {:.6}, γ = col_{}·col_{} = {:.6e}",
                p, alpha, q, beta, p, q, gamma
            );
            println!(
                "旋转角 θ = {:.6},J = [[c, s], [-s, c]] = [[{:.6}, {:.6}], [{:.6}, {:.6}]]",
                theta, c, s, -s, c
            );
            // (c) 执行 B ← B·J:J 只作用在 (p,q) 平面上,所以只有第 p、q 两列
            //     变化,其余 n−2 列原样不动(Jacobi 类算法每轮 O(m) 的原因)。
            //     两列的更新就是乘积 B·J 的列视角:
            //       col_p' = c·col_p − s·col_q
            //       col_q' = s·col_p + c·col_q
            //     这一旋转的效果:新两列的内积 γ' = ½·sin2θ·(α−β) + cos2θ·γ = 0
            //     ((b) 中选 θ 就是为了让这两项抵消),即把 Gram 的 g_pq 零化。
            for r in 0..m {
                let brp = b[[r, p]]; // 先取旧值:新 col_p 依赖旧 col_q,
                let brq = b[[r, q]]; // 若就地覆盖会先读到被污染的数据(经典陷阱)
                b[[r, p]] = c * brp - s * brq;
                b[[r, q]] = s * brp + c * brq;
            }
            // (d) 同步累积 V ← V·J:V 的第 p、q 列做与 B 完全相同的旋转。
            //   【为什么必须同步】由 (c) 每轮 B_t = B_{t-1}·J_t,递推 T 轮得
            //     B_final = A·J_1·J_2·…·J_T = A·V,其中 V = J_1·…·J_T。
            //     每轮右乘累积 J_t 正是在维护这个乘积;若不同步,
            //     收敛后无法从 B 恢复出 V,分解式 A = UΣVᵀ 就缺了 Vᵀ。
            //   【为什么旋转形式相同】V·J 的第 p、q 列更新公式与 B·J 完全一致:
            //     新_p = c·旧_p − s·旧_q,新_q = s·旧_p + c·旧_q。
            // 数学:V 始终是正交阵(正交阵的乘积仍正交:J_tᵀJ_t = I ⟹ VᵀV = I),
            //       这是后面"U 的列自动单位正交"的前提。
            for r in 0..n {
                let vrp = v[[r, p]];
                let vrq = v[[r, q]];
                v[[r, p]] = c * vrp - s * vrq;
                v[[r, q]] = s * vrp + c * vrq;
            }
            // 调试输出:各列范数即 σ_j 的当前估计,可逐轮观察收敛趋势;
            //   再与 (b) 处打印的 γ 对照 —— 该内积应已被零化
            let norms: Vec<f64> = (0..n)
                .map(|j| b.column(j).iter().map(|x| x * x).sum::<f64>().sqrt())
                .collect();
            println!("各列范数(σ 估计)= {:?}", norms);
            println!("当前累积旋转矩阵 V =\n{:?}", &v);
        }
        // (e) 收敛后 B 的列两两正交,把每个正交列单位化即拼出 U,列长即奇异值:
        //   【读出公式的来源】B 列正交 ⟹ 可唯一地写成 B = Û·Σ̂,其中
        //     Σ̂ = diag(σ_1, …, σ_n),σ_j = ‖col_j(B)‖,Û 的第 j 列 = col_j/σ_j。
        //     由 (d) 知 A = B·Vᵀ,代入:
        //        A = Û·Σ̂·Vᵀ
        //     对照 SVD 定义 A = U·Σ·Vᵀ,立即读出三个量:
        //        σ_j = ‖col_j(B)‖   (奇异值 = 正交化后列的范数)
        //        u_j = col_j(B)/σ_j (左奇异向量 = 正交列单位化)
        //        v_j = V 的第 j 列   (右奇异向量 = 累积旋转矩阵的列)
        //     u_j 自动满足单位正交:正交列同除各自范数仍正交。
        // 格式:s_vec 长度 n;u 是 m×n —— 瘦 SVD(thin SVD):
        //       m×n 矩阵只有 n 个奇异方向,U 只保留 n 列(而非 m×m 的完整 U)
        let mut s_vec = Array1::<f64>::zeros(n);
        let mut u = Array2::<f64>::zeros((m, n));
        for j in 0..n {
            // 数学:L2 范数 ‖col_j‖ = √(Σ_r b[r,j]²)
            // 实现:ndarray 0.17 已移除 .norm_l2(),这里手写——
            //   先逐元素平方、求和,再开方
            let norm = b.column(j).iter().map(|x| x * x).sum::<f64>().sqrt();
            s_vec[j] = norm;
            if norm > 1e-12 {
                // 所有权/格式:u.column_mut(j) 借出 U 第 j 列的可写视图
                //   ArrayViewMut1 —— 不拥有数据,但对 U 的内存有排他写权,
                //   通过它写入等价于直接写 u,视图在循环结束后释放
                let mut col: ArrayViewMut1<f64> = u.column_mut(j);
                for r in 0..m {
                    // 数学:u_j = b_j / σ_j,把正交列单位化成左奇异向量
                    col[r] = b[[r, j]] / norm;
                }
            }
            // norm ≤ 1e-12:该列(近)为零向量,无对应的左奇异方向,
            // U 的这一列保持 0(数值安全的兜底分支)
        }
        // (f) 奇异值降序排列,同步重排 U 的列、V 的列,保证三者序号一致。
        // 数学:PCA 要按方差贡献从大到小取主成分,所以必须降序;
        //   雅可比迭代本身不产生顺序(σ 出现在哪一列取决于旋转历史),
        //   收敛后由这一步统一排序。下面的 idx 是旧下标按 σ 降序排好的置换表
        let mut idx: Vec<usize> = (0..n).collect();
        // partial_cmp:f64 不是全序(有 NaN),只能偏序比较,故用 partial_cmp + unwrap
        // 注意比较器里 x、y 取反(s_vec[y] vs s_vec[x]),sort_by 默认升序,取反即降序
        idx.sort_by(|&x, &y| s_vec[y].partial_cmp(&s_vec[x]).unwrap());
        println!("奇异值降序置换表 idx = {:?}", &idx);
        // 格式:按置换表 gather 出排序后的三个量
        let s_sorted = Array1::from_iter(idx.iter().map(|&i| s_vec[i]));
        println!("奇异值向量降序 = {:?}", &s_sorted);
        // select(Axis(1), &idx):按列 gather —— U 的第 i 列放到新第 j 位
        let u_sorted = u.select(Axis(1), &idx);
        println!("左奇异向量矩阵 U(前 6 行)= \n{:?}", &u_sorted.slice(s![..6, ..]));
        // select 按列重排 V,再 .t() 零拷贝转置视图,.to_owned() 物化
        // 格式:Vᵀ 的第 j "行" = 第 j 个右奇异向量 v_j(与返回文档约定一致)
        let vt = v.select(Axis(1), &idx).t().to_owned();
        println!("右奇异向量矩阵 Vᵀ = \n{:?}", &vt);
        (u_sorted, s_sorted, vt, history)
    }
实现要点:
assert!(m >= n):单边雅可比的硬前提—— 个列方向要放得下 个正交向量。鸢尾花 ,天然满足。- 每轮显式构造整个 Gram 矩阵只为调试打印( 全算 16 个内积,省事且可展示); 与
gram[p][q]互为印证。 - 两个”经典陷阱”注释对应两个真实 bug 模式:就地覆盖读脏数据(先存
brp/brq再写)、以及V不同步累积导致分解缺 。 - 读出阶段是”瘦 SVD”: 只保留 列而非 。
段四:PCA 实现
// src/main.rs 段四:模块三 pca —— 两条路线的同一副面孔(fit / transform / inverse_transform)
mod pca {
    use super::*;
    use crate::linalg;

    pub struct Pca {
        pub mean: Array1<f64>,        // x̄,p 维(鸢尾花是 4 维均值向量)
        pub components: Array2<f64>,  // p×k,每"列"是一个主成分 w_j
        pub eigenvalues: Array1<f64>, // 全部 p 个 λ(降序),用于解释方差比
        pub history: Vec<f64>,        // 分解迭代收敛历史(画收敛曲线用)
    }

    impl Pca {
        /// 路线一:协方差矩阵 + 雅可比特征分解
        pub fn fit_eigen(x: &Array2<f64>, n_components: usize) -> Pca {
            let n = x.nrows(); // n = 150 个样本
            // 数学:x̄ = (1/n)·Xᵀ·1,即每列(每个特征)取算术平均
            // 格式:(n,p) 沿 Axis(0)(行方向)压缩 → 长度 p 的向量
            // 所有权:mean_axis 返回 Option(空矩阵时无均值),unwrap 取出拥有值
            let mean = x.mean_axis(Axis(0)).unwrap();
            println!("均值向量 x̄ = \n{:?}", &mean);
            // 数学:中心化 X̃ = X − 1·x̄ᵀ,每行都减去同一个均值向量
            // 格式/所有权:x 是 &Array2(借用,不被消费);&mean 也是借用;
            //   ndarray 广播规则:(n,p) − (p,) 沿行广播 → 生成"新的拥有" n×p 矩阵 xc
            let xc = x - &mean;
            let head = x.slice(s![..6, ..]); // 取前 6 行,避免输出过长
            println!("原始矩阵 X(前 6 行) = \n{:?}", head);
            let head = xc.slice(s![..6, ..]); // 取前 6 行,避免输出过长
            println!("中心化矩阵 X̃(前 6 行) = \n{:?}", head);
            // 数学:Σ = (1/n)·X̃ᵀX̃ —— 样本协方差矩阵(4×4,对称半正定)
            // 格式:.t() 是零拷贝转置视图(p×n),.dot() 矩阵乘得 p×p,
            //       再除以标量 n(逐元素)
            // 所有权:cov 是新的拥有矩阵;xc 在语句结束后仍可继续用(未被消耗)
            let cov = xc.t().dot(&xc) / n as f64;
            println!("协方差矩阵 Σ = \n{:?}", &cov);
            // 数学:解 Σw = λw(手写雅可比旋转);200 轮扫掠上限,1e-12 收敛阈值
            // 格式:返回 (λ: p 维降序, V: p×p,特征向量按列)
            let (vals, vecs, history) = linalg::jacobi_eigen_symmetric(&cov, 200, 1e-12);
            println!("jacobi_eigen_symmetric 特征值向量 = \n{:?}", &vals);
            println!("jacobi_eigen_symmetric 特征向量矩阵 V = \n{:?}", &vecs);
            // 格式:idx = [0, 1, ..., k-1],作为"取前 k 列"的列下标表
            let idx: Vec<usize> = (0..n_components).collect();
            Pca {
                // 所有权:mean 从局部变量 move 进结构体(fit_eigen 不再持有它)
                mean,
                // 格式/所有权:vecs 是拥有的 p×p,.select(Axis(1), &idx) 借用 vecs
                //   按列 gather 出 p×k 的新矩阵(前 k 个主成分);
                //   vecs 中剩下的 p−k 列在此被丢弃
                components: vecs.select(Axis(1), &idx), // 前 k 列特征向量
                // 所有权:vals(全部 p 个特征值)整体 move 进结构体,
                //   保留全部是因为解释方差比需要分母 Σλ
                eigenvalues: vals,
                history,
            }
        }

        /// 路线二:对 X̃ 直接做 SVD
        ///
        /// 【与路线一的本质区别】路线一先构造协方差矩阵 Σ = X̃ᵀX̃/n 再特征分解;
        /// 路线二跳过 Σ,直接分解数据矩阵 X̃ 本身。
        ///
        /// 【理论对应 —— 为什么 V 就是主成分】设 X̃ = U·S·Vᵀ,则
        ///     Σ = (1/n)·X̃ᵀX̃ = (1/n)·(V·Sᵀ·Uᵀ)·(U·S·Vᵀ) = (1/n)·V·S²·Vᵀ
        ///   (中间用到 UᵀU = I:瘦 SVD 的左奇异向量列正交)。
        ///   对照 PCA 的谱分解 Σ = W·Λ·Wᵀ,由特征分解的唯一性得
        ///     W = V(主成分 = 右奇异向量),λ_j = s_j²/n(特征值 = 奇异值²/样本数)。
        ///
        /// 【数值优势】κ(Σ) = κ(X̃)²。先平方构造 Σ 会把小奇异值分量淹没在
        ///   舍入误差里(近退化数据尤其明显);SVD 路线只对 X̃ 做正交旋转,
        ///   精度损失与 κ(X̃) 同阶,显著更稳。
        pub fn fit_svd(x: &Array2<f64>, n_components: usize) -> Pca {
            let n = x.nrows();
            let mean = x.mean_axis(Axis(0)).unwrap();
            println!("均值向量 x̄ = \n{:?}", &mean);
            // 数学/格式/所有权:同 fit_eigen —— 广播减法,借 x 与 mean,生成新的 n×p
            let xc = x - &mean;
            // 数学:对中心化矩阵直接做 SVD:X̃ = U·S·Vᵀ。
            //   收敛阈值 1e-10(比路线一的 1e-12 宽松是合理的):
            //   判据对象是 Gram 非对角元 γ,量级 ~σ² ~ 400,
            //   1e-10 的绝对误差对应相对误差 ~1e-13,精度仍高于路线一
            // 所有权:解构四元组 (U, S, Vᵀ, history)。U(左奇异向量)在 PCA 里用不到 —
            //   得分矩阵其实也可写成 Z = U_k·S_k,但既然已有 V 就用 Z = X̃·V_k。
            //   用 _u 占位(下划线前缀告诉编译器"有意不用",消除未使用变量警告);
            //   U 仍被正常构造,随后随 _u 一起 drop(释放 m×n 内存)
            let (_u, s, vt, history) = linalg::svd_one_sided_jacobi(&xc, 200, 1e-10);
            // 数学:λ_j = s_j²/n。推导:Σ = (1/n)X̃ᵀX̃ = (1/n)V·S²·Vᵀ(见类型文档),
            //       对照 Σ = WΛWᵀ 得 W = V、Λ = S²/n
            // 格式:s 是长度 p 的 Array1;mapv 逐元素平方后除以 n → 新的拥有向量
            println!("svd_one_sided_jacobi 奇异值向量 σ = \n{:?}", &s);
            let eigenvalues = s.mapv(|v| v * v / n as f64);
            println!("换算后的特征值 λ = σ²/n = \n{:?}", &eigenvalues);
            let idx: Vec<usize> = (0..n_components).collect();
            Pca {
                mean,
                // 数学/格式:函数返回的是 Vᵀ(右奇异向量按"行"存放),取主成分即取 V 的前 k 列。
                //   实现路径:vt.select(Axis(0), &idx) 先按行取前 k 个 → k×p,
                //   .t() 零拷贝转置成 p×k 视图,.to_owned() 物化成拥有矩阵,
                //   使第 j 列 = v_j —— 与路线一 components 的约定一致(每列一个主成分),
                //   于是两条路线可以共用同一个 transform 公式 Z = X̃·W_k
                components: vt.select(Axis(0), &idx).t().to_owned(), // V 的前 k 列
                eigenvalues,
                history,
            }
        }

        /// 投影 Z = X̃·W_k:n×p 乘 p×k → n×k
        /// 数学:把每个样本投到前 k 个主成分方向上,坐标即主成分得分
        pub fn transform(&self, x: &Array2<f64>) -> Array2<f64> {
            // 数学:先对新数据做同样的中心化(用训练期保存的 mean,不是新数据的均值)
            // 格式/所有权:同前,广播减法生成临时 n×p
            let xc = x - &self.mean;
            // 数学:Z = X̃·W_k,标准矩阵乘法(ndarray dot)
            // 格式:n×p · p×k → n×k 得分矩阵
            // 所有权:components 以 & 借用(&self),xc 作为左操作数被 dot 消耗,
            //   返回新的拥有矩阵
            xc.dot(&self.components)
        }

        /// 重建 X̂ = Z·W_kᵀ + 1·x̄ᵀ
        /// 数学:把 k 维得分投回 p 维空间(丢掉的分量补 0),再加回均值
        pub fn inverse_transform(&self, z: &Array2<f64>) -> Array2<f64> {
            // 数学/格式:Z·W_kᵀ 是 n×k · k×p → n×p(components.t() 零拷贝转置视图),
            //   + &self.mean 沿行广播加回均值 → n×p 重建数据
            // 所有权:z 与 mean 都是 & 借用,结果为新拥有矩阵
            z.dot(&self.components.t()) + &self.mean
        }

        /// 解释方差比 λ_j / Σλ
        /// 数学:第 j 个主成分方向占全部方差的比例;累计和常用于"取多少主成分"
        pub fn explained_variance_ratio(&self) -> Vec<f64> {
            // 数学:总方差 = 全部特征值之和(= 各特征方差之和)
            let total: f64 = self.eigenvalues.sum();
            // 格式:Array1 的迭代器逐元素相除,collect 成标准库 Vec<f64>
            self.eigenvalues.iter().map(|l| l / total).collect()
        }
    }
}
实现要点:
- 两条路线收敛到同一副 API:
fit_eigen/fit_svd产出相同的Pca结构体,之后transform/inverse_transform/explained_variance_ratio完全共用——路线差异被锁在 fit 里。 components的列约定统一为”每列一个主成分”:路线二的 取行后转置物化,就是为了和路线一vecs的列语义对齐。_u占位:左奇异向量 在 PCA 里用不上(得分用 而非 ),下划线前缀消警告, 照常构造后随绑定丢弃。transform用训练期保存的均值中心化新数据——这是机器学习里”训练/推理同分布”的最小案例。
段五:main——两条路线对比验证 + 可视化
// src/main.rs 段五:main —— 读数据、跑两条路线、一致性检查、重建误差、三张图
use io::{load_csv_labels, load_csv_numeric, CsvPath};
use pca::Pca;

fn main() -> Result<(), Box<dyn Error>> {
    // ---- 1. 读数据(150×4,species 列被自动剔除;标签单独读一份供分色)----
    // 所有权:? 传播错误;成功后 x 拥有 150×4 矩阵,main 结束前一直有效
    let csv_path = CsvPath { path: "data/iris.csv", has_header: true };
    let x = load_csv_numeric(CsvPath { path: csv_path.path, has_header: csv_path.has_header })?;
    let labels = load_csv_labels(CsvPath { path: csv_path.path, has_header: csv_path.has_header }, "species")?;
    let (n, p) = x.dim(); // 格式:解构形状 (150, 4)
    println!("数据加载成功: {} 样本 × {} 特征\n", n, p);

    let out_dir = "../../../frontend/public/images/series/rust-ml-14-pca";
    std::fs::create_dir_all(out_dir).expect("创建输出目录失败");

    let k = 2; // 保留前 2 个主成分

    // ---- 2. 路线一:特征分解 ----
    // 所有权:&x 借用(fit 不消费数据);model_eig 拥有均值/成分/特征值
    println!("[路线一] 协方差矩阵特征分解:");
    // 计时:Instant::now() 取当前时刻,elapsed() 得时间间隔
    // 注意:耗时包含 fit 内部调试打印的 IO 开销
    let t_eig = Instant::now();
    let model_eig = Pca::fit_eigen(&x, k);
    let dt_eig = t_eig.elapsed();

    println!("mean        = \n{:?}", model_eig.mean);
    println!("eigenvalues = \n{:?}", model_eig.eigenvalues);
    println!("components  = \n{:#?}", model_eig.components);
    print_report(&model_eig, k); // & 借用模型,只读打印

    // ---- 3. 路线二:SVD ----
    // 数学:理论证明两条路线给出相同的主成分(至多差一个符号),此处数值验证。
    //   期望输出与路线一逐项一致:λ 相同(max|Δλ| ~ 1e-15),
    //   components 逐列相同或整体反号(符号不唯一性)
    println!("\n[路线二] 对中心化数据直接 SVD(λ_j = s_j²/n):");
    let t_svd = Instant::now();
    let model_svd = Pca::fit_svd(&x, k);
    let dt_svd = t_svd.elapsed();

    println!("mean        = \n{:?}", model_svd.mean);
    println!("eigenvalues = \n{:?}", model_svd.eigenvalues);
    println!("components  = \n{:#?}", model_svd.components);
    print_report(&model_svd, k);

    // ---- 3.5 耗时对比 ----
    // 数学:路线一的成本 = 构造协方差矩阵 X̃ᵀX̃(O(n·p²) 矩阵乘)+ p×p 雅可比迭代;
    //   路线二跳过协方差构造,直接对 n×p 数据迭代,每轮只旋两列 O(m)。
    //   理论上 n=150 时路线一的一次 n·p² 矩阵乘 ≈ 路线二三十轮迭代的内积总量,
    //   两者同阶;真正的耗时差异主要来自迭代轮数和打印量。
    // 注意:两个耗时都包含调试打印(每轮打印 4×4 矩阵)的 IO 开销
    println!(
        "\n[耗时对比] 路线一(协方差+特征分解): {:?}\n           路线二(直接 SVD):         {:?}\n           路线一 / 路线二 = {:.2} 倍",
        dt_eig,
        dt_svd,
        dt_eig.as_secs_f64() / dt_svd.as_secs_f64()
    );

    // ---- 4. 验证两条路线等价:特征值之差、投影得分之差 ----
    // 数学:max|λ_eig − λ_svd| 应只含浮点误差(~1e-15 量级)
    // 所有权:&Array1 − &Array1 → 新 Array1(不消费两个模型的 eigenvalues);
    //   .mapv(f64::abs) 逐元素取绝对值 → 又一个新数组
    // 数学:ndarray 0.17 已移除数组的 .max() 方法,改为迭代器折叠求最大;
    //   f64 未实现 Ord(有 NaN),不能用 Iterator::max,故用 f64::max 折叠
    let d_lambda = (&model_eig.eigenvalues - &model_svd.eigenvalues)
        .mapv(f64::abs)
        .iter()
        .copied()
        .fold(0.0f64, f64::max);
    // 格式:两个 n×k 得分矩阵;&x 继续被借用(x 仍归 main 所有)
    let z_eig = model_eig.transform(&x);
    let z_svd = model_svd.transform(&x);
    // 数学:max|Z_eig − Z_svd|。注意主成分符号不唯一,
    //   若某列符号相反此处会很大 —— 本实现两条路线的 V 同号,故应接近 0
    // 所有权/格式:二维数组同样先广播减法、逐元素取绝对值,
    //   再摊平成迭代器折叠求最大(fold 起点 0.0:距离非负)
    let d_score = (&z_eig - &z_svd)
        .mapv(f64::abs)
        .iter()
        .copied()
        .fold(0.0f64, f64::max);
    println!("\n两条路线一致性检查:");
    println!("  max|λ_eig - λ_svd|   = {:.3e}", d_lambda);
    println!("  max|Z_eig - Z_svd|   = {:.3e}", d_score);

    // ---- 5. 重建误差(用路线一)----
    // 数学:X̂ = Z·W_kᵀ + x̄ᵀ,与原始 X 比较
    // 所有权:z_eig 以 & 借用(后面作图还要用 z,这里不消费)
    let x_hat = model_eig.inverse_transform(&z_eig);
    // 数学:MSE = mean((X − X̂)²),对全部 n×p 个元素取均方。
    //   注意与"被丢弃方差"差一个特征数 p 的因子:
    //   MSE = (1/(n·p))Σ‖残差‖² = (λ_丢弃和) / p
    // 所有权:&x − &x_hat → 新矩阵;mapv 平方;mean() 得 Option<f64>;unwrap
    let mse = (&x - &x_hat).mapv(|v| v * v).mean().unwrap();
    // 数学:解释方差比;1 − 累计 = 被丢弃的方差占比(λ3+λ4 占比)
    let ratio = model_eig.explained_variance_ratio();
    println!("\n重建均方误差 (k=2): {:.6}", mse);
    // 数学:1 − (λ1+λ2)/(λ1+...+λ4) = 被丢弃的方差占比
    // 格式:ratio[..k] 切出前 k 个比例,iter().sum::<f64>() 求标量和
    println!("理论丢弃方差比: {:.6}", 1.0 - ratio[..k].iter().sum::<f64>());

    // ---- 6. 可视化 ----
    // 图一:两条路线的收敛曲线(每轮最大非对角元/最大 Gram 非对角元 → 0)
    let h1_len = model_eig.history.len() as f64;
    let h2_len = model_svd.history.len() as f64;
    let max_len = h1_len.max(h2_len);
    let conv1: Vec<(f64, f64)> = model_eig.history.iter().enumerate().map(|(i, &v)| (i as f64 + 1.0, v)).collect();
    let conv2: Vec<(f64, f64)> = model_svd.history.iter().enumerate().map(|(i, &v)| (i as f64 + 1.0, v)).collect();
    let mut c = Canvas::new(560.0, 420.0, 1.0, max_len, 0.0, conv1.iter().chain(conv2.iter()).map(|p| p.1).fold(0.0f64, f64::max));
    c.axes("迭代轮次", "最大非对角元 |A_pq| / |γ|");
    c.polyline(&conv1, PALETTE[0], 2.2);
    c.polyline(&conv2, PALETTE[1], 2.2);
    c.legend(&[("路线一·EVD", PALETTE[0]), ("路线二·SVD", PALETTE[1])]);
    let p1 = format!("{out_dir}/jacobi-convergence.svg");
    c.save(&p1);

    // 图二:PC1–PC2 投影散点,按物种分色(鸢尾花 PCA 的成名图)
    // 数学:Z = X̃·W_k 的第 1、2 列即前两个主成分得分
    // 格式:n×k 得分矩阵 → 按标签分三组的 (z1, z2) 点集
    let z = model_eig.transform(&x);
    let classes = ["Iris-setosa", "Iris-versicolor", "Iris-virginica"];
    let mut c = Canvas::new(560.0, 420.0, -4.0, 4.0, -2.0, 2.0);
    c.axes("PC1", "PC2");
    for (ci, cls) in classes.iter().enumerate() {
        let pts: Vec<(f64, f64)> = (0..n)
            .filter(|&i| labels.get(i).map(|l| l == cls).unwrap_or(false))
            .map(|i| (z[[i, 0]], z[[i, 1]]))
            .collect();
        c.dots(&pts, PALETTE[ci], 3.0);
    }
    c.legend(&[
        ("setosa", PALETTE[0]),
        ("versicolor", PALETTE[1]),
        ("virginica", PALETTE[2]),
    ]);
    let p2 = format!("{out_dir}/iris-pc1-pc2.svg");
    c.save(&p2);

    // 图三:累计方差贡献率——"保留前 k 个主成分"的可视答案
    let cum: Vec<(f64, f64)> = {
        let ratio = model_eig.explained_variance_ratio();
        let mut acc = 0.0;
        ratio
            .iter()
            .enumerate()
            .map(|(j, &r)| {
                acc += r;
                (j as f64 + 1.0, acc)
            })
            .collect()
    };
    let mut c = Canvas::new(560.0, 420.0, 1.0, 4.0, 0.0, 1.05);
    c.axes("主成分个数 k", "累计方差贡献率");
    c.polyline(&cum, PALETTE[0], 2.2);
    let kpt = vec![(k as f64, 0.0), (k as f64, cum[k - 1].1)];
    c.polyline(&kpt, PALETTE[3], 1.6);
    c.legend(&[("累计贡献率", PALETTE[0]), ("k=2 的选择", PALETTE[3])]);
    let p3 = format!("{out_dir}/variance-scree.svg");
    c.save(&p3);

    println!("图已写入:{p1}、{p2}、{p3}");

    Ok(())
}

fn print_report(model: &Pca, k: usize) {
    // 数学:逐主成分打印 λ、方差比、累计方差比
    let ratio = model.explained_variance_ratio();
    let mut cum = 0.0; // 累计方差比,滚动累加
    for j in 0..model.eigenvalues.len() {
        cum += ratio[j];
        println!(
            "  PC{}: λ = {:.6}  ratio = {:.4}  cumulative = {:.4}{}",
            j + 1,
            model.eigenvalues[j],
            ratio[j],
            cum,
            // 数学:前 k 个是被保留的主成分,打印时标记出来
            if j < k { "  <== 保留" } else { "" }
        );
    }
}
实现要点:
- 结果一致性检查:
max|Δλ| = 7.5e-16——两条独立实现的路线在浮点尾差内收敛到同一答案。 - MSE 与丢弃方差比的关系差一个因子 :MSE 对 个元素平均,丢弃方差对 个样本平均。,与实测吻合。
- 计时仅作参考:两个数字都含逐轮打印的 IO 开销,且 4 维问题太小,不能外推性能结论。
段六:迷你 SVG 绘图器
// src/main.rs 段六:迷你 SVG 绘图器(与系列前篇同一份实现)
use std::fmt::Write as _;

/// 系列默认配色:朱橙 / 青绿 / 蓝 / 琥珀(取自站点设计令牌)。
const PALETTE: [&str; 4] = ["#d6491f", "#0f766e", "#2563eb", "#d97706"];

/// 一张图:坐标映射 + 已累积的 SVG 元素。
struct Canvas {
    w: f64,
    h: f64,
    xmin: f64,
    xmax: f64,
    ymin: f64,
    ymax: f64,
    pad_l: f64,
    pad_r: f64,
    pad_t: f64,
    pad_b: f64,
    body: String,
}

impl Canvas {
    /// 按数据范围自动留 5% 边距建图;xmin == xmax 时手动摊开避免除零。
    fn new(w: f64, h: f64, xmin: f64, xmax: f64, ymin: f64, ymax: f64) -> Canvas {
        let (xmin, xmax) = spread(xmin, xmax);
        let (ymin, ymax) = spread(ymin, ymax);
        Canvas {
            w,
            h,
            xmin,
            xmax,
            ymin,
            ymax,
            pad_l: 52.0,
            pad_r: 16.0,
            pad_t: 16.0,
            pad_b: 40.0,
            body: String::new(),
        }
    }

    fn px(&self, x: f64) -> f64 {
        self.pad_l + (x - self.xmin) / (self.xmax - self.xmin) * (self.w - self.pad_l - self.pad_r)
    }

    fn py(&self, y: f64) -> f64 {
        self.h - self.pad_b - (y - self.ymin) / (self.ymax - self.ymin) * (self.h - self.pad_t - self.pad_b)
    }

    /// 折线,点需按 x 升序传入。
    fn polyline(&mut self, pts: &[(f64, f64)], color: &str, width: f64) {
        let mut d = String::new();
        for (i, (x, y)) in pts.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}" fill="none" stroke="{color}" stroke-width="{width}" stroke-linejoin="round"/>"##
        );
    }

    /// 散点。
    fn dots(&mut self, pts: &[(f64, f64)], color: &str, r: f64) {
        for (x, y) in pts {
            let _ = write!(
                self.body,
                r##"<circle cx="{:.1}" cy="{:.1}" r="{r}" fill="{color}" fill-opacity="0.65"/>"##,
                self.px(*x),
                self.py(*y)
            );
        }
    }

    /// 坐标轴 + 虚线网格 + 刻度标签。
    fn axes(&mut self, xlabel: &str, ylabel: &str) {
        let x0 = self.px(self.xmin);
        let x1 = self.px(self.xmax);
        let y0 = self.py(self.ymin);
        let y1 = self.py(self.ymax);
        for t in nice_ticks(self.xmin, self.xmax, 6) {
            let x = self.px(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x:.1}" y1="{y0:.1}" x2="{x:.1}" y2="{y1:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{x:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                y0 + 16.0,
                t = trim(t)
            );
        }
        for t in nice_ticks(self.ymin, self.ymax, 6) {
            let y = self.py(t);
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{x1:.1}" y2="{y:.1}" stroke="#16161d" stroke-opacity="0.08"/>"##
            );
            let _ = write!(
                self.body,
                r##"<text x="{:.1}" y="{:.1}" text-anchor="end" fill="#16161d" fill-opacity="0.45">{t:.6}</text>"##,
                x0 - 6.0,
                y + 4.0,
                t = trim(t)
            );
        }
        let _ = write!(
            self.body,
            r##"<path d="M{x0:.1},{y0:.1}H{x1:.1}M{x0:.1},{y0:.1}V{y1:.1}" fill="none" stroke="#16161d" stroke-opacity="0.6"/>"##
        );
        let _ = write!(
            self.body,
            r##"<text x="{:.1}" y="{:.1}" text-anchor="middle" fill="#16161d" fill-opacity="0.7">{xlabel}</text>"##,
            (x0 + x1) / 2.0,
            self.h - 8.0
        );
        let _ = write!(
            self.body,
            r##"<text x="14" y="{:.1}" text-anchor="middle" transform="rotate(-90 14 {:.1})" fill="#16161d" fill-opacity="0.7">{ylabel}</text>"##,
            (y0 + y1) / 2.0,
            (y0 + y1) / 2.0
        );
    }

    /// 置信带:upper/lower 两条曲线围成的区域,半透明填充。
    #[allow(dead_code)] // 部分篇章不使用,保持各篇绘图器逐字一致
    fn band(&mut self, upper: &[(f64, f64)], lower: &[(f64, f64)], color: &str) {
        let mut d = String::new();
        for (i, (x, y)) in upper.iter().enumerate() {
            let _ = write!(d, "{}{:.1},{:.1}", if i == 0 { "M" } else { "L" }, self.px(*x), self.py(*y));
        }
        for (x, y) in lower.iter().rev() {
            let _ = write!(d, "L{:.1},{:.1}", self.px(*x), self.py(*y));
        }
        let _ = write!(
            self.body,
            r##"<path d="{d}Z" fill="{color}" fill-opacity="0.15" stroke="none"/>"##
        );
    }

    /// 图例:右上角依次画「色线 + 文字」。
    fn legend(&mut self, entries: &[(&str, &str)]) {
        let sample_w = 22.0;
        let line_h = 18.0;
        let x_text = self.w - self.pad_r - 78.0 + sample_w + 6.0;
        for (i, (label, color)) in entries.iter().enumerate() {
            let y = self.pad_t + 14.0 + i as f64 * line_h;
            let x0 = self.w - self.pad_r - 78.0;
            let _ = write!(
                self.body,
                r##"<line x1="{x0:.1}" y1="{y:.1}" x2="{:.1}" y2="{y:.1}" stroke="{color}" stroke-width="2.5"/>"##,
                x0 + sample_w
            );
            let _ = write!(
                self.body,
                r##"<text x="{x_text:.1}" y="{:.1}" fill="#16161d" fill-opacity="0.7">{label}</text>"##,
                y + 4.0
            );
        }
    }

    fn save(&self, path: &str) {
        let svg = format!(
            r##"<svg xmlns="http://www.w3.org/2000/svg" viewBox="0 0 {w} {h}" font-family="'JetBrains Mono',monospace" font-size="11"><rect width="{w}" height="{h}" fill="#fbfaf7"/>{body}</svg>"##,
            w = self.w,
            h = self.h,
            body = self.body
        );
        std::fs::write(path, svg).expect("写 SVG 失败");
    }
}

/// 把 fmt 出来的 f64 末尾零去掉,让刻度标签短一点。
fn trim(v: f64) -> String {
    let s = format!("{v:.6}");
    s.trim_end_matches('0').trim_end_matches('.').to_string()
}

/// 数据范围退化成一点时向两侧摊开。
fn spread(min: f64, max: f64) -> (f64, f64) {
    if min == max {
        (min - 1.0, max + 1.0)
    } else {
        let pad = (max - min) * 0.05;
        (min - pad, max + pad)
    }
}

/// “好看”的刻度:步长取 1/2/2.5/5 × 10^k。
fn nice_ticks(min: f64, max: f64, n: usize) -> Vec<f64> {
    let raw = (max - min) / n.max(1) as f64;
    if raw <= 0.0 || !raw.is_finite() {
        return vec![min];
    }
    let exp = raw.abs().log10().floor() as i32;
    let base = 10f64.powi(exp);
    let frac = raw / base;
    let step = if frac <= 1.0 {
        base
    } else if frac <= 2.0 {
        2.0 * base
    } else if frac <= 2.5 {
        2.5 * base
    } else if frac <= 5.0 {
        5.0 * base
    } else {
        10.0 * base
    };
    let mut ticks = Vec::new();
    let mut t = (min / step).ceil() * step;
    while t <= max + 1e-9 {
        ticks.push(if t.abs() < step * 1e-9 { 0.0 } else { t });
        t += step;
    }
    ticks
}
段七:单元测试
// src/main.rs 段七:单元测试(cargo test 运行)
#[cfg(test)]
mod tests {
    use super::*;
    use crate::linalg::{jacobi_eigen_symmetric, svd_one_sided_jacobi};
    use crate::pca::Pca;

    /// 读真实 iris.csv:150 行、4 个数值列(尾部空行已被清洗)
    #[test]
    fn iris_csv_loads_150_by_4() {
        let x = load_csv_numeric(CsvPath { path: "data/iris.csv", has_header: true }).unwrap();
        assert_eq!(x.dim(), (150, 4));
        assert!(x.iter().all(|v| v.is_finite()));
    }

    /// 两条路线给出的特征值必须一致(至多浮点尾差)
    #[test]
    fn two_routes_agree_on_eigenvalues() {
        let x = load_csv_numeric(CsvPath { path: "data/iris.csv", has_header: true }).unwrap();
        let m1 = Pca::fit_eigen(&x, 2);
        let m2 = Pca::fit_svd(&x, 2);
        let d = (&m1.eigenvalues - &m2.eigenvalues)
            .mapv(f64::abs)
            .iter()
            .copied()
            .fold(0.0f64, f64::max);
        assert!(d < 1e-8, "max|Δλ| = {}", d);
    }

    /// 特征向量矩阵 V 必须正交单位:VᵀV ≈ I;且 ΣV − λV 残差足够小
    #[test]
    fn jacobi_eigenpairs_are_orthonormal() {
        let x = load_csv_numeric(CsvPath { path: "data/iris.csv", has_header: true }).unwrap();
        let n = x.nrows() as f64;
        let mean = x.mean_axis(Axis(0)).unwrap();
        let xc = &x - &mean;
        let cov = xc.t().dot(&xc) / n;
        let (vals, vecs, _) = jacobi_eigen_symmetric(&cov, 200, 1e-12);
        let p = vals.len();
        // 正交单位:VᵀV 的非对角元 ≈ 0、对角元 ≈ 1
        let vt_v = vecs.t().dot(&vecs);
        for i in 0..p {
            for j in 0..p {
                let expect = if i == j { 1.0 } else { 0.0 };
                assert!((vt_v[[i, j]] - expect).abs() < 1e-10, "VᵀV[{}][{}] = {}", i, j, vt_v[[i, j]]);
            }
        }
        // 特征对方程 Σv = λv 的残差
        for j in 0..p {
            let vj = vecs.column(j);
            let av = cov.dot(&vj);
            let lv = &av - &(&vj * vals[j]);
            let res: f64 = lv.iter().map(|x| x.abs()).fold(0.0f64, f64::max);
            assert!(res < 1e-10, "λ_{} 残差 = {}", j, res);
        }
    }

    /// SVD 路线满足 σ_j²/n = λ_j(与路线一交叉验证)
    #[test]
    fn svd_sigma_squared_equals_eigenvalue() {
        let x = load_csv_numeric(CsvPath { path: "data/iris.csv", has_header: true }).unwrap();
        let n = x.nrows() as f64;
        let mean = x.mean_axis(Axis(0)).unwrap();
        let xc = &x - &mean;
        let (_, s, vt, _) = svd_one_sided_jacobi(&xc, 200, 1e-10);
        let m1 = Pca::fit_eigen(&x, 4);
        for j in 0..4 {
            let lam_svd = s[j] * s[j] / n;
            assert!((lam_svd - m1.eigenvalues[j]).abs() < 1e-8, "j={}", j);
        }
        // Vᵀ 来自 SVD:行正交单位
        let v = vt.t();
        let vt_v = v.t().dot(&v);
        for i in 0..4 {
            for j in 0..4 {
                let expect = if i == j { 1.0 } else { 0.0 };
                assert!((vt_v[[i, j]] - expect).abs() < 1e-10);
            }
        }
    }

    /// k=2 重建的均方误差 ≈ 总方差 × 被丢弃方差比 ÷ 特征数 p
    #[test]
    fn reconstruction_loss_matches_discarded_variance() {
        let x = load_csv_numeric(CsvPath { path: "data/iris.csv", has_header: true }).unwrap();
        let m = Pca::fit_eigen(&x, 2);
        let z = m.transform(&x);
        let x_hat = m.inverse_transform(&z);
        let mse = (&x - &x_hat).mapv(|v| v * v).mean().unwrap();
        let ratio = m.explained_variance_ratio();
        let total_var: f64 = m.eigenvalues.sum();
        let discarded: f64 = 1.0 - ratio[..2].iter().sum::<f64>();
        // 数学:MSE 对 n×p 个元素取平均,而被丢弃方差 Σλ_dropped = (1/n)·Σ‖残差‖²
        //   (只对 n 个样本平均)——两者差一个特征数 p 的因子:MSE = 总方差×丢弃比 / p
        let expect = total_var * discarded / x.ncols() as f64;
        assert!((mse - expect).abs() < 1e-8 * expect, "mse={} expect={}", mse, expect);
    }
}
实现要点:
two_routes_agree_on_eigenvalues检查结果一致性:max|Δλ| < 1e-8(实测 7.5e-16)。jacobi_eigenpairs_are_orthonormal矩阵检查:(正交单位)+ 残差(特征对方程)。- 重建测试固化了 MSE 与丢弃方差的因子关系(差一个 )——写测试的过程本身就是一次量纲检查。
Rust 语法角:所有权三态——move、& 借用与 view 视图
本篇代码注释里反复出现三个标签:所有权 / 格式 / 数学。数学是公式,格式是形状变换,而所有权是 Rust 独有的一道工序。同一个数据在 Python 里只有一种处理方式(名字都是引用,拷贝是隐式的 copy()),在 Rust 里却要在三种状态中选择:
- move(搬走):
cols.push(Array1::from_vec(v))——Vec<f64>的堆缓冲直接搬进 ndarray,没有复制。Python 里np.array(v)视实现而定共享还是拷贝,Rust 把这个选择写进了类型系统,默认搬走。 - & 借用(只读):
jacobi_eigen_symmetric(&cov, ...)借走协方差矩阵,函数内a.to_owned()拷一份”工作副本”再原地改——调用者的cov从头到尾有效。对比 Python:函数拿到的是引用,原地改会静默污染调用者的变量;Rust 里&承诺只读,想改必须显式拷贝。 - view 视图(零拷贝窗口):
x.slice(s![..6, ..])、xc.t()、cols.iter().map(|c| c.view())——都只是(指针 + 形状 + 步长)的观察窗,不碰数据。stack(Axis(0), &views)拼完即弃,.t().to_owned()才把视图物化成拥有矩阵。Python 的X[:6]与X.T也是视图,但视图什么时候失效是运行时的事;Rust 的生命周期把”视图活得比数据久”变成编译期错误。
一句话对照:Python 靠约定防止函数篡改调用者的数据,Rust 靠编译器——违反借用规则的代码直接编译失败。代价是处处标注 &、.to_owned()、生命周期——本篇的注释约定就是给这堂所有权课做的脚注。见《Rust 程序设计语言》ch04-01(所有权) 与 ch04-02(引用与借用)。
运行结果
cargo test(5 个用例:CSV 形状、两路线 λ 一致、特征对正交单位、σ²/n=λ、重建损失=丢弃方差/p)全部通过。cargo run 保留全部逐轮调试输出(共 16 轮 × 两条路线),下面是关键节选——完整输出可克隆仓库复现:
数据加载成功: 150 样本 × 4 特征

[路线一] 协方差矩阵特征分解:
均值向量 x̄ =
[5.843333333333335, 3.0540000000000007, 3.7586666666666693, 1.1986666666666672, ...]
协方差矩阵 Σ =
[[0.6811222222222222, -0.03900666666666667, 1.2651911111111114, 0.5134577777777779],
 [-0.03900666666666667, 0.1867506666666667, -0.3195680000000001, -0.11719466666666667],
 [1.2651911111111114, -0.3195680000000001, 3.0924248888888854, 1.2877448888888892],
 [0.5134577777777779, -0.11719466666666667, 1.2877448888888892, 0.5785315555555559]], ...

========== [路线一·协方差特征分解] 迭代轮次 1 ==========
最大非对角元 |a[2][3]| = 1.287745e0
消元对象 a[2][3] = 1.287745e0,主子块对角 a[2][2] = 3.092425, a[3][3] = 0.578532
旋转角 θ = 1.172046,J = [[c, s], [-s, c]] = [[0.388267, 0.921547], [-0.921547, 0.388267]]
旋转后 A =
[[0.6811222222222222, -0.03900666666666667, 0.018056436559767353, 1.3652916912857214],
 [-0.03900666666666667, 0.1867506666666667, -0.016077302967331203, -0.33999973065931655],
 [0.018056436559767353, -0.016077302967331203, 0.03597778551655062, 0.0],
 [1.3652916912857214, -0.33999973065931655, 0.0, 3.634978658927891]], ...
已收敛(max_val < tol = 1e-12),共迭代 16 轮

[路线二] 对中心化数据直接 SVD(λ_j = s_j²/n):
========== [路线二·单边雅可比 SVD] 迭代轮次 1 ==========
最大列间内积 |col_2 · col_3| = 1.931617e2
α = ‖col_2‖² = 463.863733, β = ‖col_3‖² = 86.779733, γ = col_2·col_3 = 1.931617e2
旋转角 θ = 1.172046,J = [[c, s], [-s, c]] = [[0.388267, 0.921547], [-0.921547, 0.388267]]
已收敛(max_g < tol = 1e-10),共迭代 16 轮

[耗时对比] 路线一(协方差+特征分解): 3.0198ms
           路线二(直接 SVD):         5.5886ms
           路线一 / 路线二 = 0.54 倍

两条路线一致性检查:
  max|λ_eig - λ_svd|   = 7.529e-16
  max|Z_eig - Z_svd|   = 1.554e-15

重建均方误差 (k=2): 0.025381
理论丢弃方差比: 0.022368
主成分报告(两条路线逐字一致):
  PC1: λ = 4.196675  ratio = 0.9246  cumulative = 0.9246  <== 保留
  PC2: λ = 0.240629  ratio = 0.0530  cumulative = 0.9776  <== 保留
  PC3: λ = 0.078000  ratio = 0.0172  cumulative = 0.9948
  PC4: λ = 0.023525  ratio = 0.0052  cumulative = 1.0000
三张图(全部由文章自带的迷你 SVG 绘图器生成):
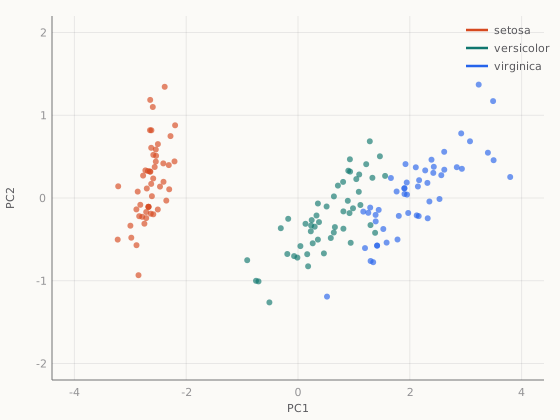
怎么读这些数字和图
- 第一轮的两个 θ 完全相同(1.172046):并非巧合,而是 的直接推论——两条路线第一轮消的是同一个 主子块(只差一个因子 150)。用”第 4 块”的公式即可手算复核这个数。
max|Δλ| = 7.5e-16:两条独立实现的路线在机器精度内收敛到同一组特征值。单元测试two_routes_agree_on_eigenvalues把这个观察固化成了断言。- 收敛曲线:两条路线都是 16 轮归零。注意路线二的纵轴量级(~200)是 Gram 内积( 的尺度),路线一是协方差尺度——曲线形状(先慢后快、尾部二次收敛)才是可比的。
- PC1–PC2 散点:setosa(朱橙)被 PC1 彻底分离;versicolor 与 virginica 有少量重叠——这正是”前两个主成分保留 97.8% 信息”的几何样子:4 维里的结构,2 维里基本没丢。
- 累计贡献率图:k=1 已达 92.5%,k=2 升到 97.8%,之后是长尾。“保留多少主成分”由此有了量化的取舍依据。
- 重建 MSE = 0.025381:对照理论值 总方差 4.538830 × 丢弃比 0.022368 ÷ p=4 = 0.025381——损失精确等于被丢弃的方差(除以特征数),降维的”账单”是闭合的。
优缺点与适用场景
- 优点:无监督、无参数、计算快、去噪去相关。
- 缺点:只能捕捉线性结构(非线性流形无能为力,那是核 PCA 的地盘)、对离群值敏感(协方差被极端值拖着走)、主成分可解释性差( 的线性组合常说不清物理意义)。
- 适用场景:数据预处理(去共线、压缩存储)、可视化(压到 2/3 维直接画图)、噪声过滤。
小结
PCA 展示了无监督学习的经典思想:不需要答案,只需要度量方差。工具仍是那套线性代数,区别只在于提问方式。就实现而言,sklearn/LAPACK 的路线在速度与数值稳定性上更为成熟,工程上应直接使用;手写实现的意义在于把黑盒拆开:分治与随机化算法、BLAS 调优、 分母,每处工程差异背后都是同一个数学对象,也都可以像这样手算复核,所谓的算法本质就是数学,无非是把数学公式翻译成计算机能执行的步骤,只是当基本算子通过 BLAS/ndarray/NumPy 封装后,很多细节被隐藏了,以至于有意识或无意识地忽略了这些算法的数学本质,也许本身就是一个误解。Rust 语言的所有权系统让我们在实现算法时更清楚地意识到数据的生命周期和内存管理,这对于理解和实现复杂算法如 PCA 是非常有帮助的。接受复杂度的代价是代码中需要更多的显式标注和生命周期管理,但这也带来了更高的安全性和性能优化空间。 算法实现的很多问题都是在权衡复杂度和可维护性之间做出选择,人生也是如此。